최종 업데이트: 2026-09-17
크롤링 중 만나는 HTTP 403 Forbidden 은 “서버가 요청을 이해했지만 의도적으로 거절했다”는 응답이에요. 원인은 ① User-Agent 등 요청 헤더, ② 쿠키·세션 부재, ③ Cloudflare·Akamai 류 봇 감지, ④ 데이터센터 IP 평판, ⑤ 속도 제한(rate limit) 다섯 갈래로 나뉘고, 비용이 싼 ①부터 순서대로 시도하면 대부분 30분 안에 원인이 갈려요. 이 글은 Python requests 와 Selenium 코드, curl 진단 순서, 그리고 화장품 앱 COSMO 수집기가 올리브영에서 403 을 두 번 맞고 해결한 실측 기록을 정리해요.
올리브영은 사례 중 하나예요. 어느 사이트든 진단 순서는 같아요. 브라우저 주소창에 넣어도 안 열리는 페이지(로그인·지역·권한 제한)는 크롤링 문제가 아니므로 이 글의 범위 밖이에요.
403 Forbidden 은 404 나 401 과 무엇이 다른가요?
MDN 의 403 정의에 따르면 403 은 서버가 클라이언트를 식별했고 요청도 이해했지만 권한을 주지 않는 상태예요. 404 는 자원이 없는 것이고, 401 은 “누군지 모르니 인증하라”는 뜻이에요. 401 이면 인증 헤더나 로그인 쿠키 문제이고, 403 이면 아래 다섯 갈래 중 하나예요.
크롤러 입장에서 중요한 차이는 이거예요. 403 은 서버가 요청의 무언가를 보고 거절한 것이라, 그 “무언가”가 헤더인지 IP 인지 요청 빈도인지만 가르면 해법이 정해져요.
크롤링 403 원인 5갈래와 해결 시간
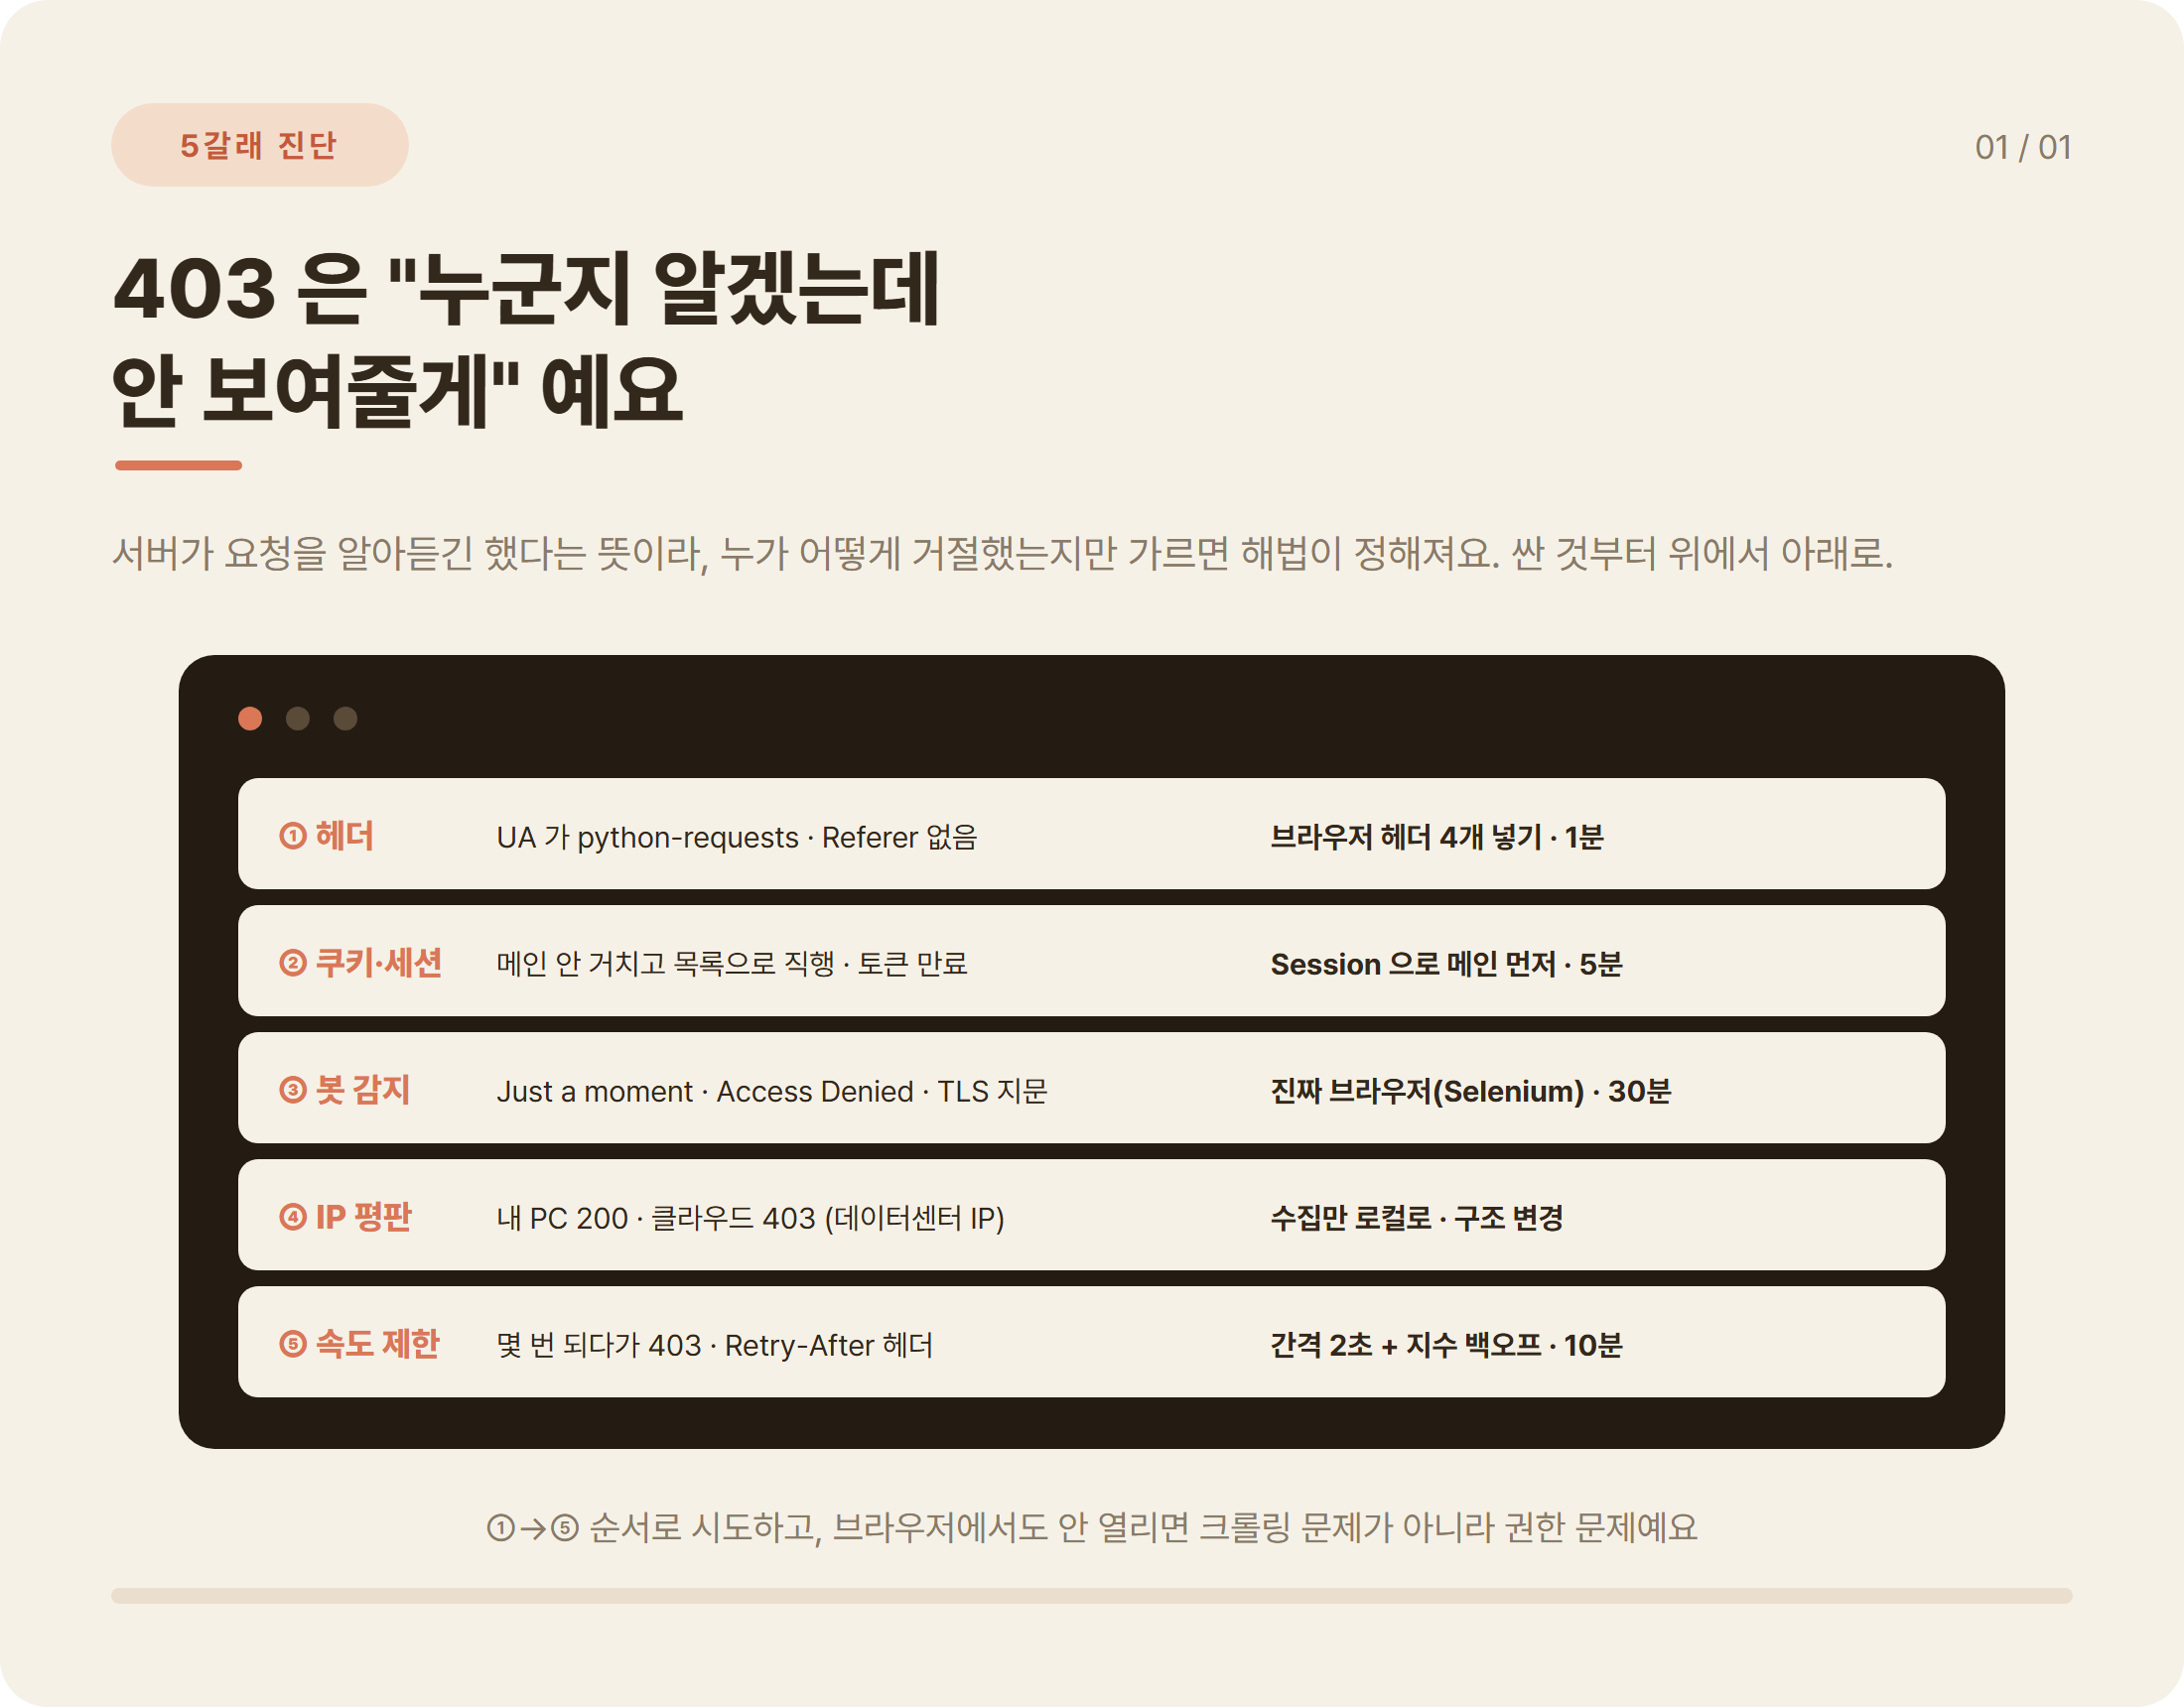
| 갈래 | 서버가 본 것 | 신호 | 해결 | 걸리는 시간 |
|---|---|---|---|---|
| ① 헤더 | User-Agent 가 python-requests, Referer 없음 | UA 만 붙이면 200 | 브라우저 헤더 4개 | 1분 |
| ② 쿠키·세션 | 메인을 거치지 않고 목록 URL 직행, 토큰 만료 | 로그인 페이지로 리다이렉트 | requests.Session 으로 메인 먼저 | 5분 |
| ③ 봇 감지 | JavaScript 미실행, TLS 지문이 브라우저가 아님 | Just a moment / Access Denied | 진짜 브라우저 (Selenium·Playwright) | 30분 |
| ④ IP 평판 | 데이터센터 IP 대역 (AWS·GCP·Cloud Run) | 내 PC 200, 클라우드 403 | 수집만 로컬로, 구조 변경 | 반나절 |
| ⑤ 속도 제한 | 짧은 시간에 요청 과다 | 몇 번 되다가 403, Retry-After 헤더 | 요청 간격 + 지수 백오프 | 10분 |
순서가 곧 비용이에요. ①② 는 코드 몇 줄, ③ 은 브라우저 자동화 도입, ④ 는 실행 환경 변경, ⑤ 는 대기 로직이에요. ①부터 확인하고 안 될 때만 다음으로 내려가세요.
실제로 만나는 403 문구 5가지 (트러블슈팅)
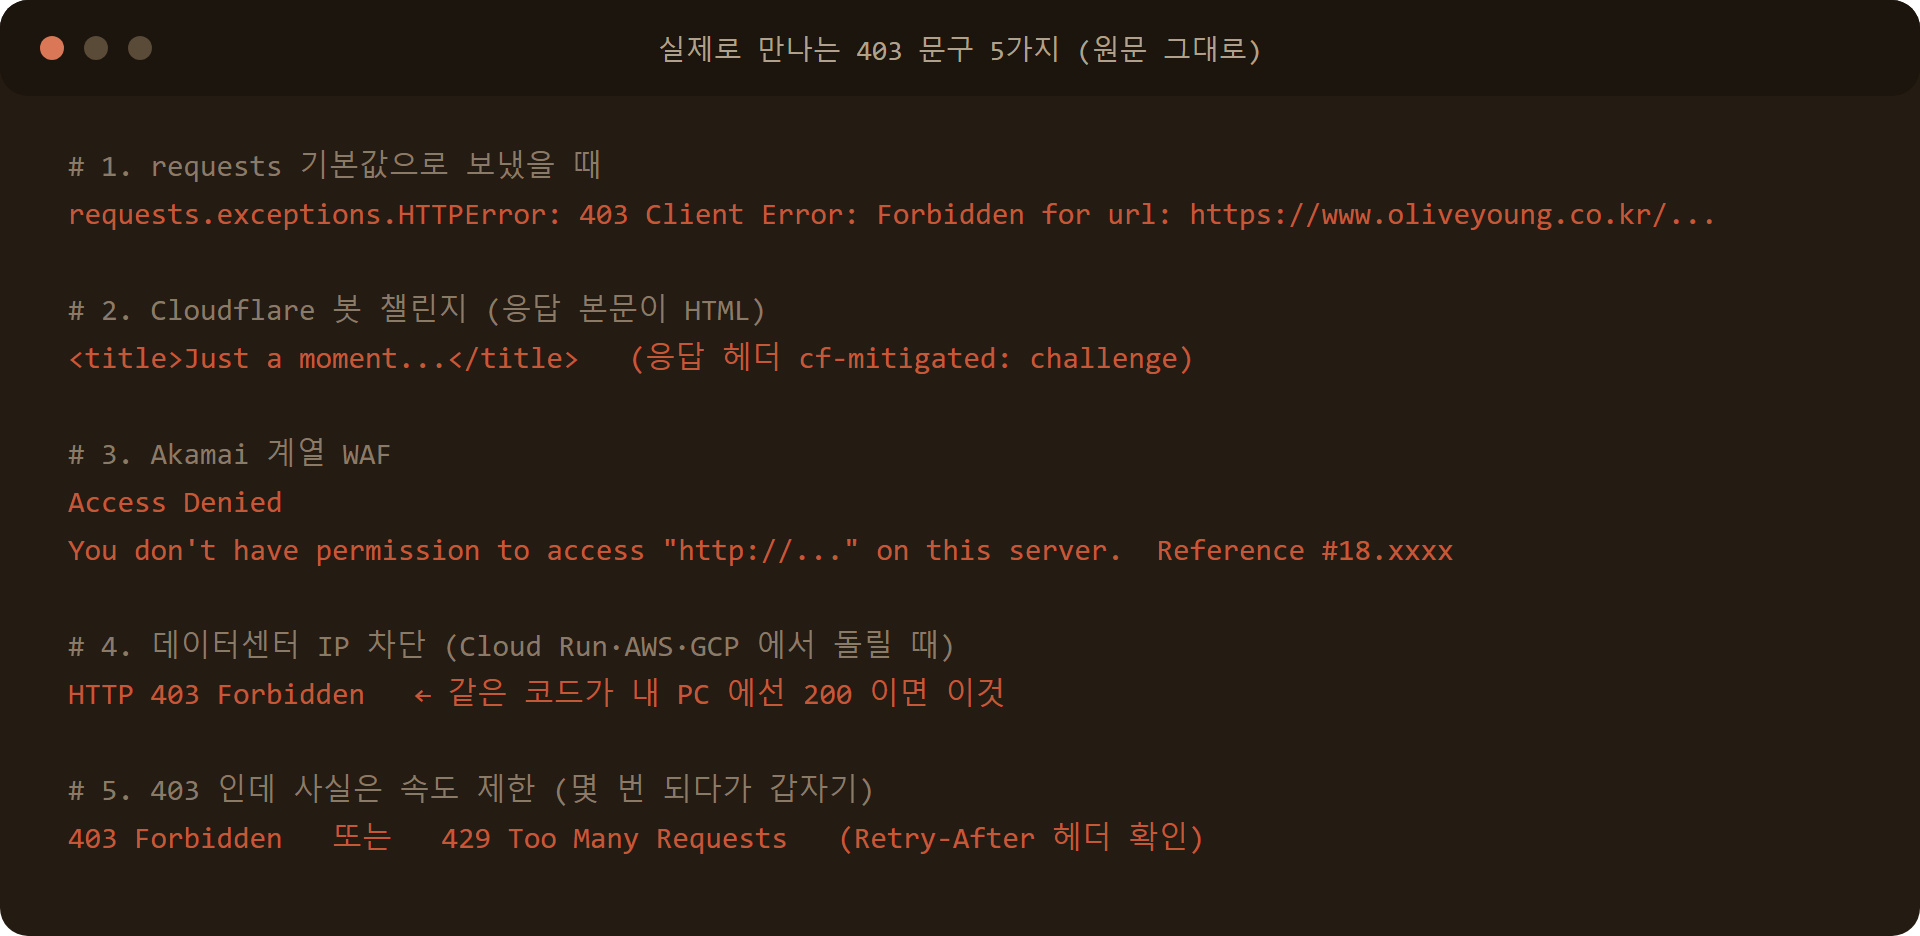
# 실제로 만나는 403 문구 5가지 (원문 그대로)
# 1. requests 기본값으로 보냈을 때
requests.exceptions.HTTPError: 403 Client Error: Forbidden for url: https://www.oliveyoung.co.kr/...

# 2. Cloudflare 봇 챌린지 (응답 본문이 HTML)
<title>Just a moment...</title>   (응답 헤더 cf-mitigated: challenge)

# 3. Akamai 계열 WAF
Access Denied
You don't have permission to access "http://..." on this server.  Reference #18.xxxx

# 4. 데이터센터 IP 차단 (Cloud Run·AWS·GCP 에서 돌릴 때)
HTTP 403 Forbidden   ← 같은 코드가 내 PC 에선 200 이면 이것

# 5. 403 인데 사실은 속도 제한 (몇 번 되다가 갑자기)
403 Forbidden 또는 429 Too Many Requests (Retry-After 헤더 확인)- requests.exceptions.HTTPError: 403 Client Error: Forbidden for url. requests 가 raise_for_status() 에서 던지는 문구예요. ①②⑤ 어느 갈래든 가능하니 이 문구만으로는 원인을 못 정해요. 아래 curl 진단으로 가르세요.
- <title>Just a moment…</title>. Cloudflare 챌린지 페이지예요. 응답 헤더에 cf-mitigated: challenge 가 붙어요. 갈래 ③, requests 로는 못 넘고 브라우저가 필요해요.
- Access Denied. You don’t have permission to access “…” on this server. Reference #18.xxxx. Akamai 계열 WAF 의 차단 페이지예요. 갈래 ③ 또는 ④ 예요. 같은 코드가 다른 네트워크에서 되면 ④ 예요.
- HTTP 403 Forbidden (클라우드에서만). 코드가 같은데 내 PC 에서는 200, Cloud Run·AWS 에서는 403 이면 데이터센터 IP 대역 차단이에요. 갈래 ④, 코드로는 못 고쳐요.
- 403 또는 429 Too Many Requests (몇 번 되다가). 속도 제한이에요. 원래 429 가 맞지만 403 으로 주는 사이트가 많아요. 응답 헤더 Retry-After 를 확인하세요. 갈래 ⑤ 예요.
30초 만에 원인 갈래를 가르는 curl 진단 순서는?
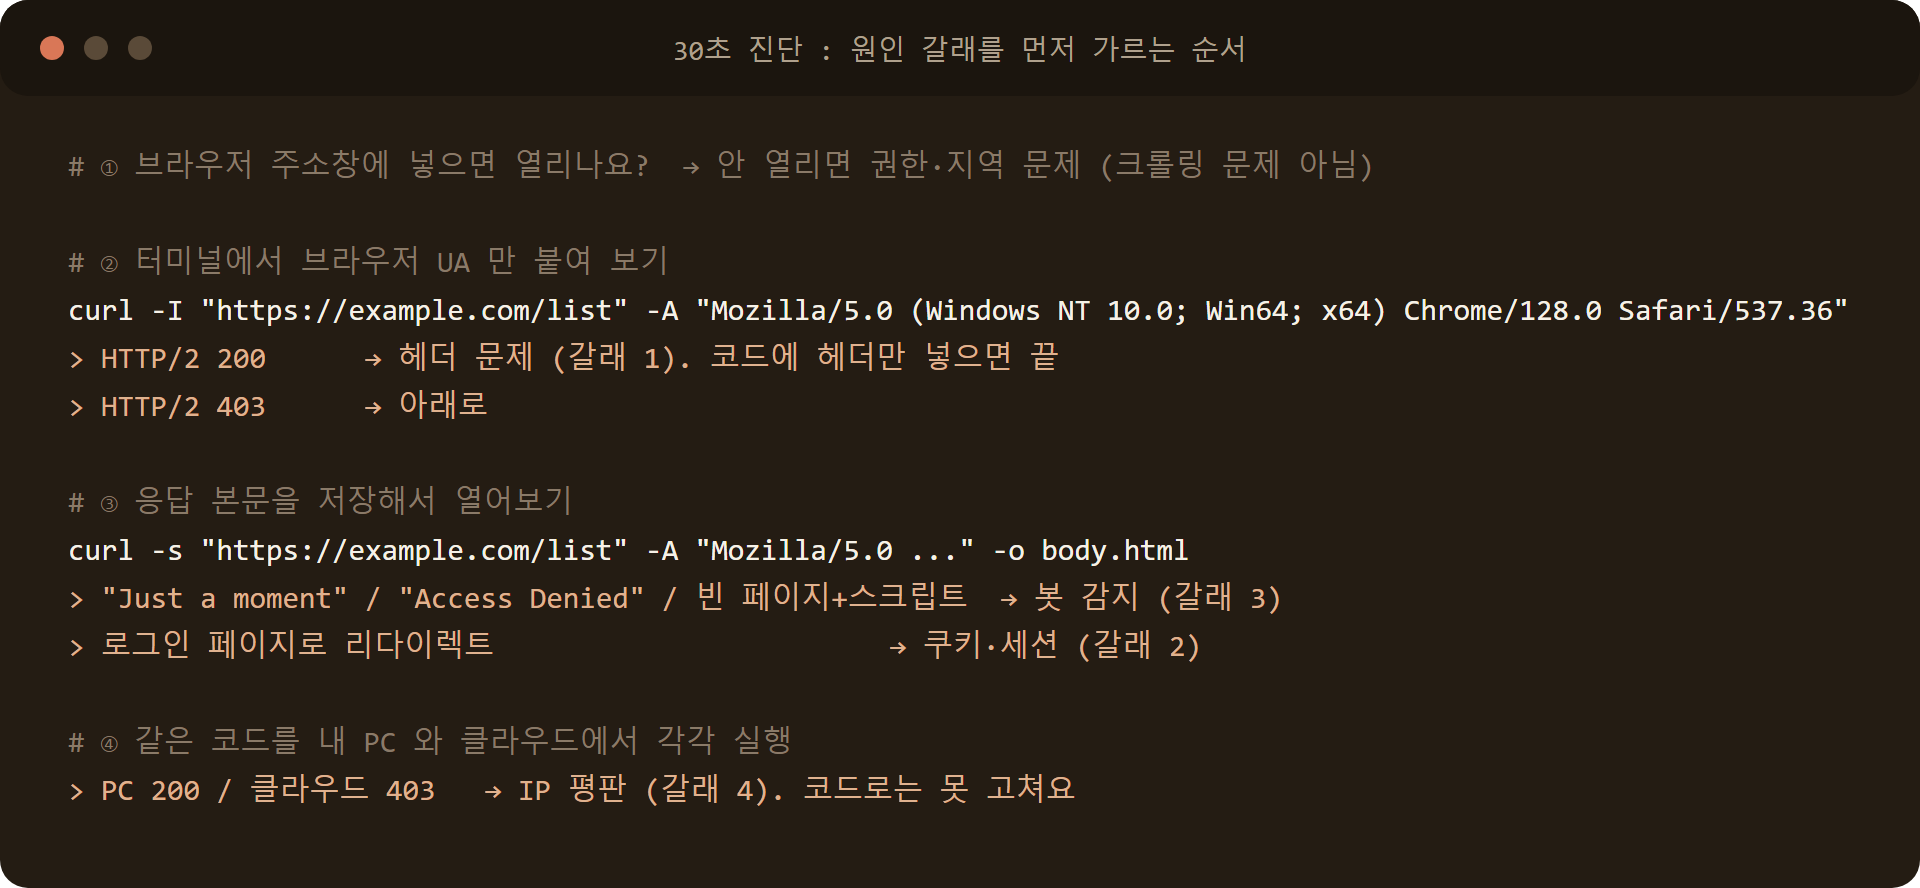
# 30초 진단 : 원인 갈래를 먼저 가르는 순서
# ① 브라우저 주소창에 넣으면 열리나요?  → 안 열리면 권한·지역 문제 (크롤링 문제 아님)

# ② 터미널에서 브라우저 UA 만 붙여 보기
curl -I "https://example.com/list" -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/128.0 Safari/537.36"
> HTTP/2 200      → 헤더 문제 (갈래 1). 코드에 헤더만 넣으면 끝
> HTTP/2 403      → 아래로

# ③ 응답 본문을 저장해서 열어보기
curl -s "https://example.com/list" -A "Mozilla/5.0 ..." -o body.html
> "Just a moment" / "Access Denied" / 빈 페이지+스크립트  → 봇 감지 (갈래 3)
> 로그인 페이지로 리다이렉트                        → 쿠키·세션 (갈래 2)

# ④ 같은 코드를 내 PC 와 클라우드에서 각각 실행
> PC 200 / 클라우드 403 → IP 평판 (갈래 4). 코드로는 못 고쳐요- 브라우저에서 열리는지 확인해요. 안 열리면 권한 문제라 여기서 끝이에요.
- curl 에 -A 로 브라우저 UA 만 붙여 보내요. 200 이면 갈래 ①, 헤더만 넣으면 해결이에요.
- 응답 본문을 파일로 저장해서 열어요. 챌린지 페이지면 ③, 로그인 페이지로 리다이렉트면 ② 예요.
- 같은 코드를 내 PC 와 클라우드에서 각각 실행해요. 결과가 다르면 ④ IP 평판이에요.
- 처음엔 되다가 막히면 ⑤ 속도 제한이에요. Retry-After 헤더가 있는지 보세요.
갈래 ①② 해결: requests 로 브라우저처럼 보이는 세션 만들기
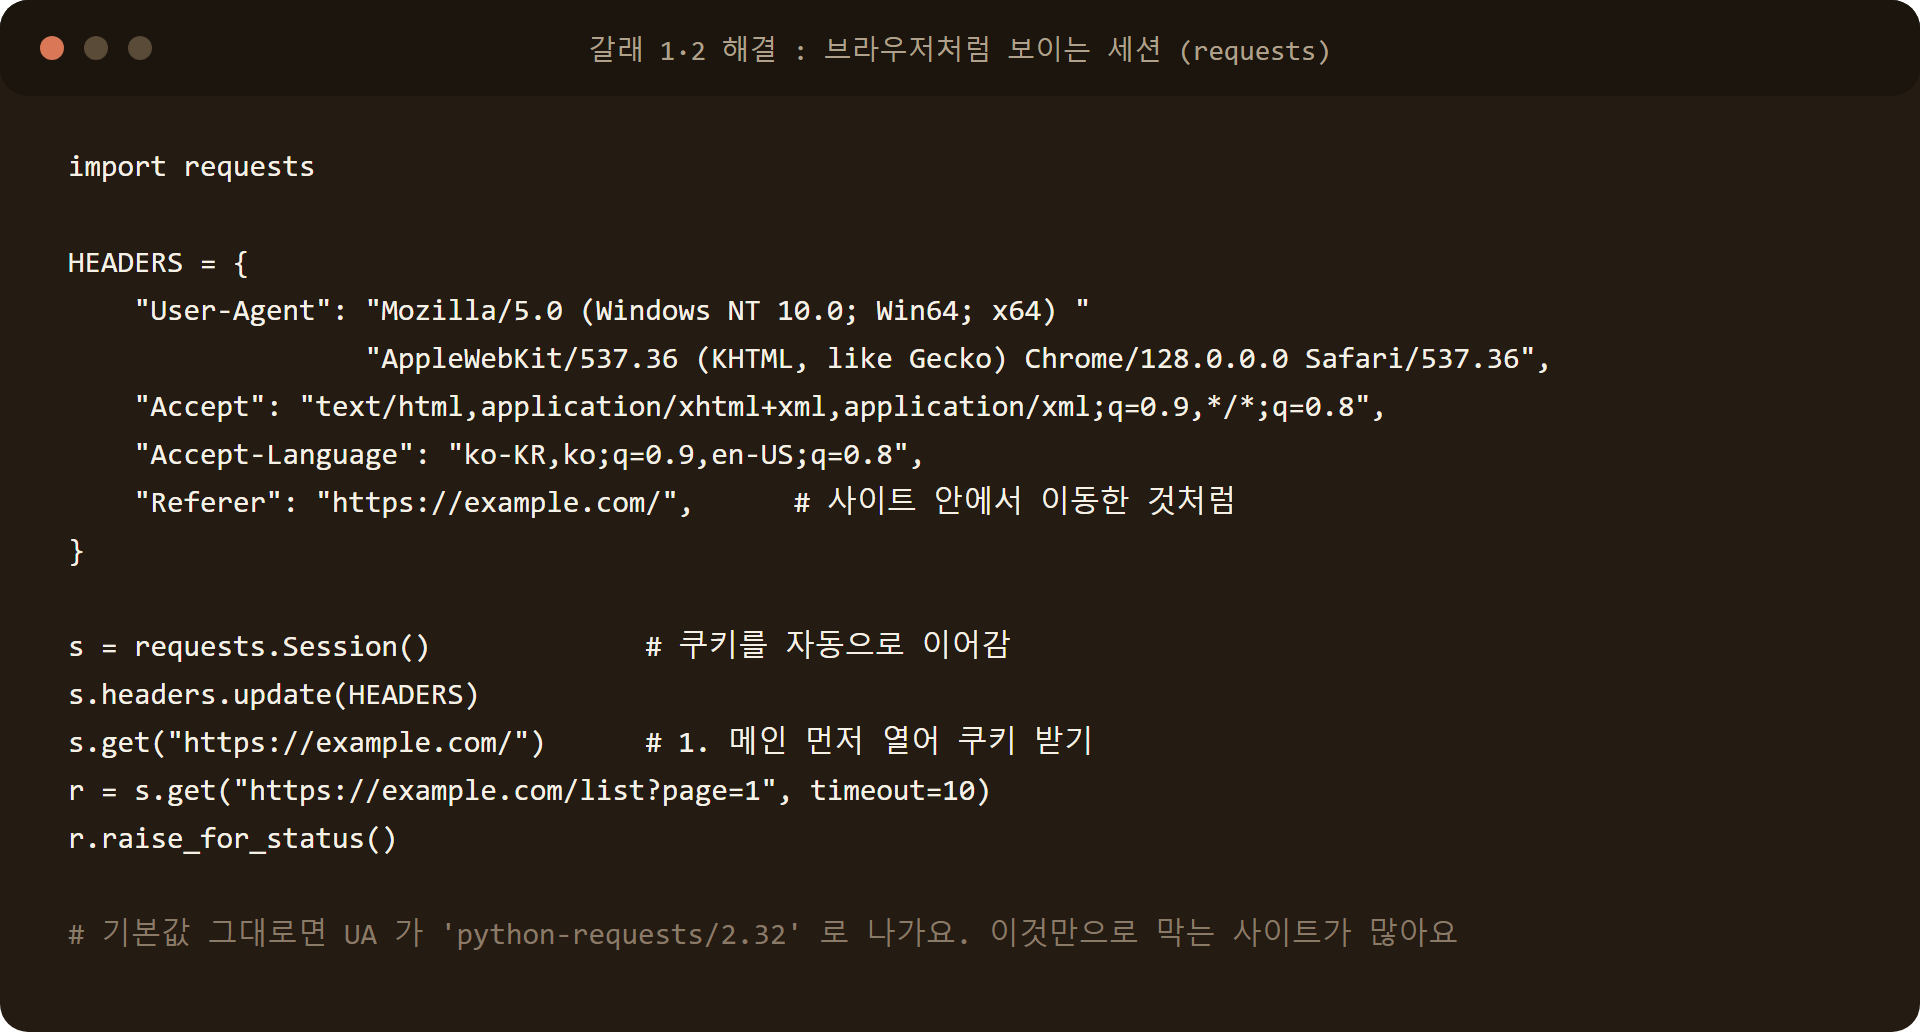
# 갈래 1·2 해결 : 브라우저처럼 보이는 세션 (requests)
import requests

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "ko-KR,ko;q=0.9,en-US;q=0.8",
    "Referer": "https://example.com/",      # 사이트 안에서 이동한 것처럼
}

s = requests.Session()             # 쿠키를 자동으로 이어감
s.headers.update(HEADERS)
s.get("https://example.com/")      # 1. 메인 먼저 열어 쿠키 받기
r = s.get("https://example.com/list?page=1", timeout=10)
r.raise_for_status()

# 기본값 그대로면 UA 가 'python-requests/2.32' 로 나가요. 이것만으로 막는 사이트가 많아요
requests 의 기본 User-Agent 는 python-requests/2.x 예요. 이 문자열 하나로 막는 사이트가 많아요. User-Agent, Accept, Accept-Language, Referer 네 개를 세트로 넣고, requests.Session 으로 메인 페이지를 먼저 열어 쿠키를 받은 뒤 목록 페이지로 가면 ①② 는 대부분 풀려요.
주의할 점은 헤더의 일관성이에요. UA 는 최신 Chrome 인데 Accept-Language 가 비어 있거나 Referer 가 다른 도메인이면 오히려 봇으로 분류돼요. 네 개를 함께 넣으세요.
갈래 ③ 해결: Selenium headless Chrome 으로 진짜 브라우저 열기
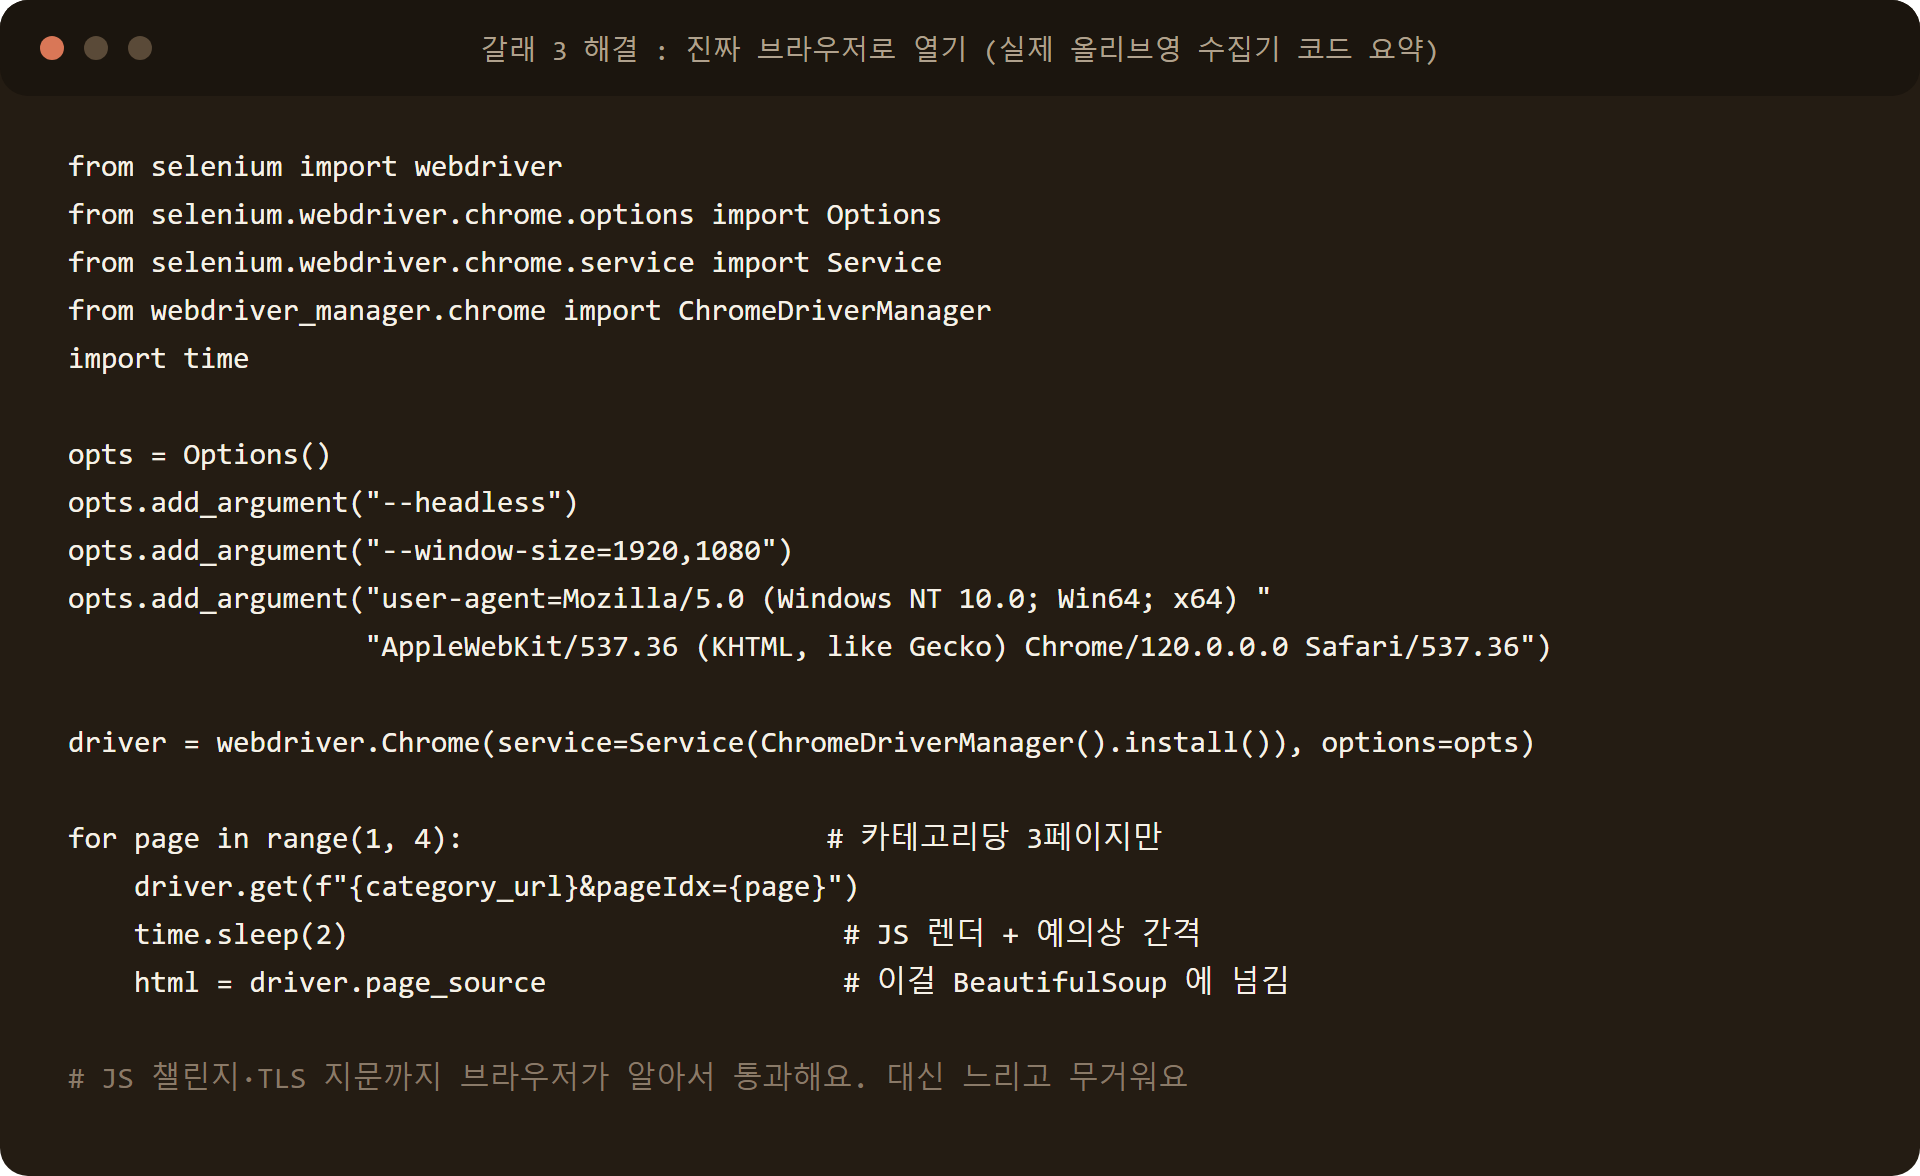
# 갈래 3 해결 : 진짜 브라우저로 열기 (실제 올리브영 수집기 코드 요약)
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
import time

opts = Options()
opts.add_argument("--headless")
opts.add_argument("--window-size=1920,1080")
opts.add_argument("user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36")

driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()), options=opts)

for page in range(1, 4):                      # 카테고리당 3페이지만
    driver.get(f"{category_url}&pageIdx={page}")
    time.sleep(2)                              # JS 렌더 + 예의상 간격
    html = driver.page_source                  # 이걸 BeautifulSoup 에 넘김

# JS 챌린지·TLS 지문까지 브라우저가 알아서 통과해요. 대신 느리고 무거워요
Cloudflare 나 Akamai 의 봇 감지는 JavaScript 실행 여부와 TLS 핸드셰이크 지문까지 봐요. 헤더를 아무리 맞춰도 requests 는 여기서 막혀요. 이때는 headless Chrome 을 띄우는 것이 확실해요. 위 코드는 COSMO 올리브영 수집기에서 실제로 쓰는 드라이버 설정이고, Selenium Chrome 옵션 문서 기준이에요. webdriver-manager 가 chromedriver 를 자동으로 받아 버전 불일치 문제가 없어요.
대가는 속도와 자원이에요. 페이지당 2초씩 대기하고 메모리는 수백 MB 를 써요. 그래서 ①② 로 풀리는지 먼저 확인하고, 안 될 때만 브라우저로 가는 것이 순서예요.
갈래 ④ 해결: 코드로 못 고치는 IP 차단은 실행 위치를 바꿔요 (올리브영 실전)
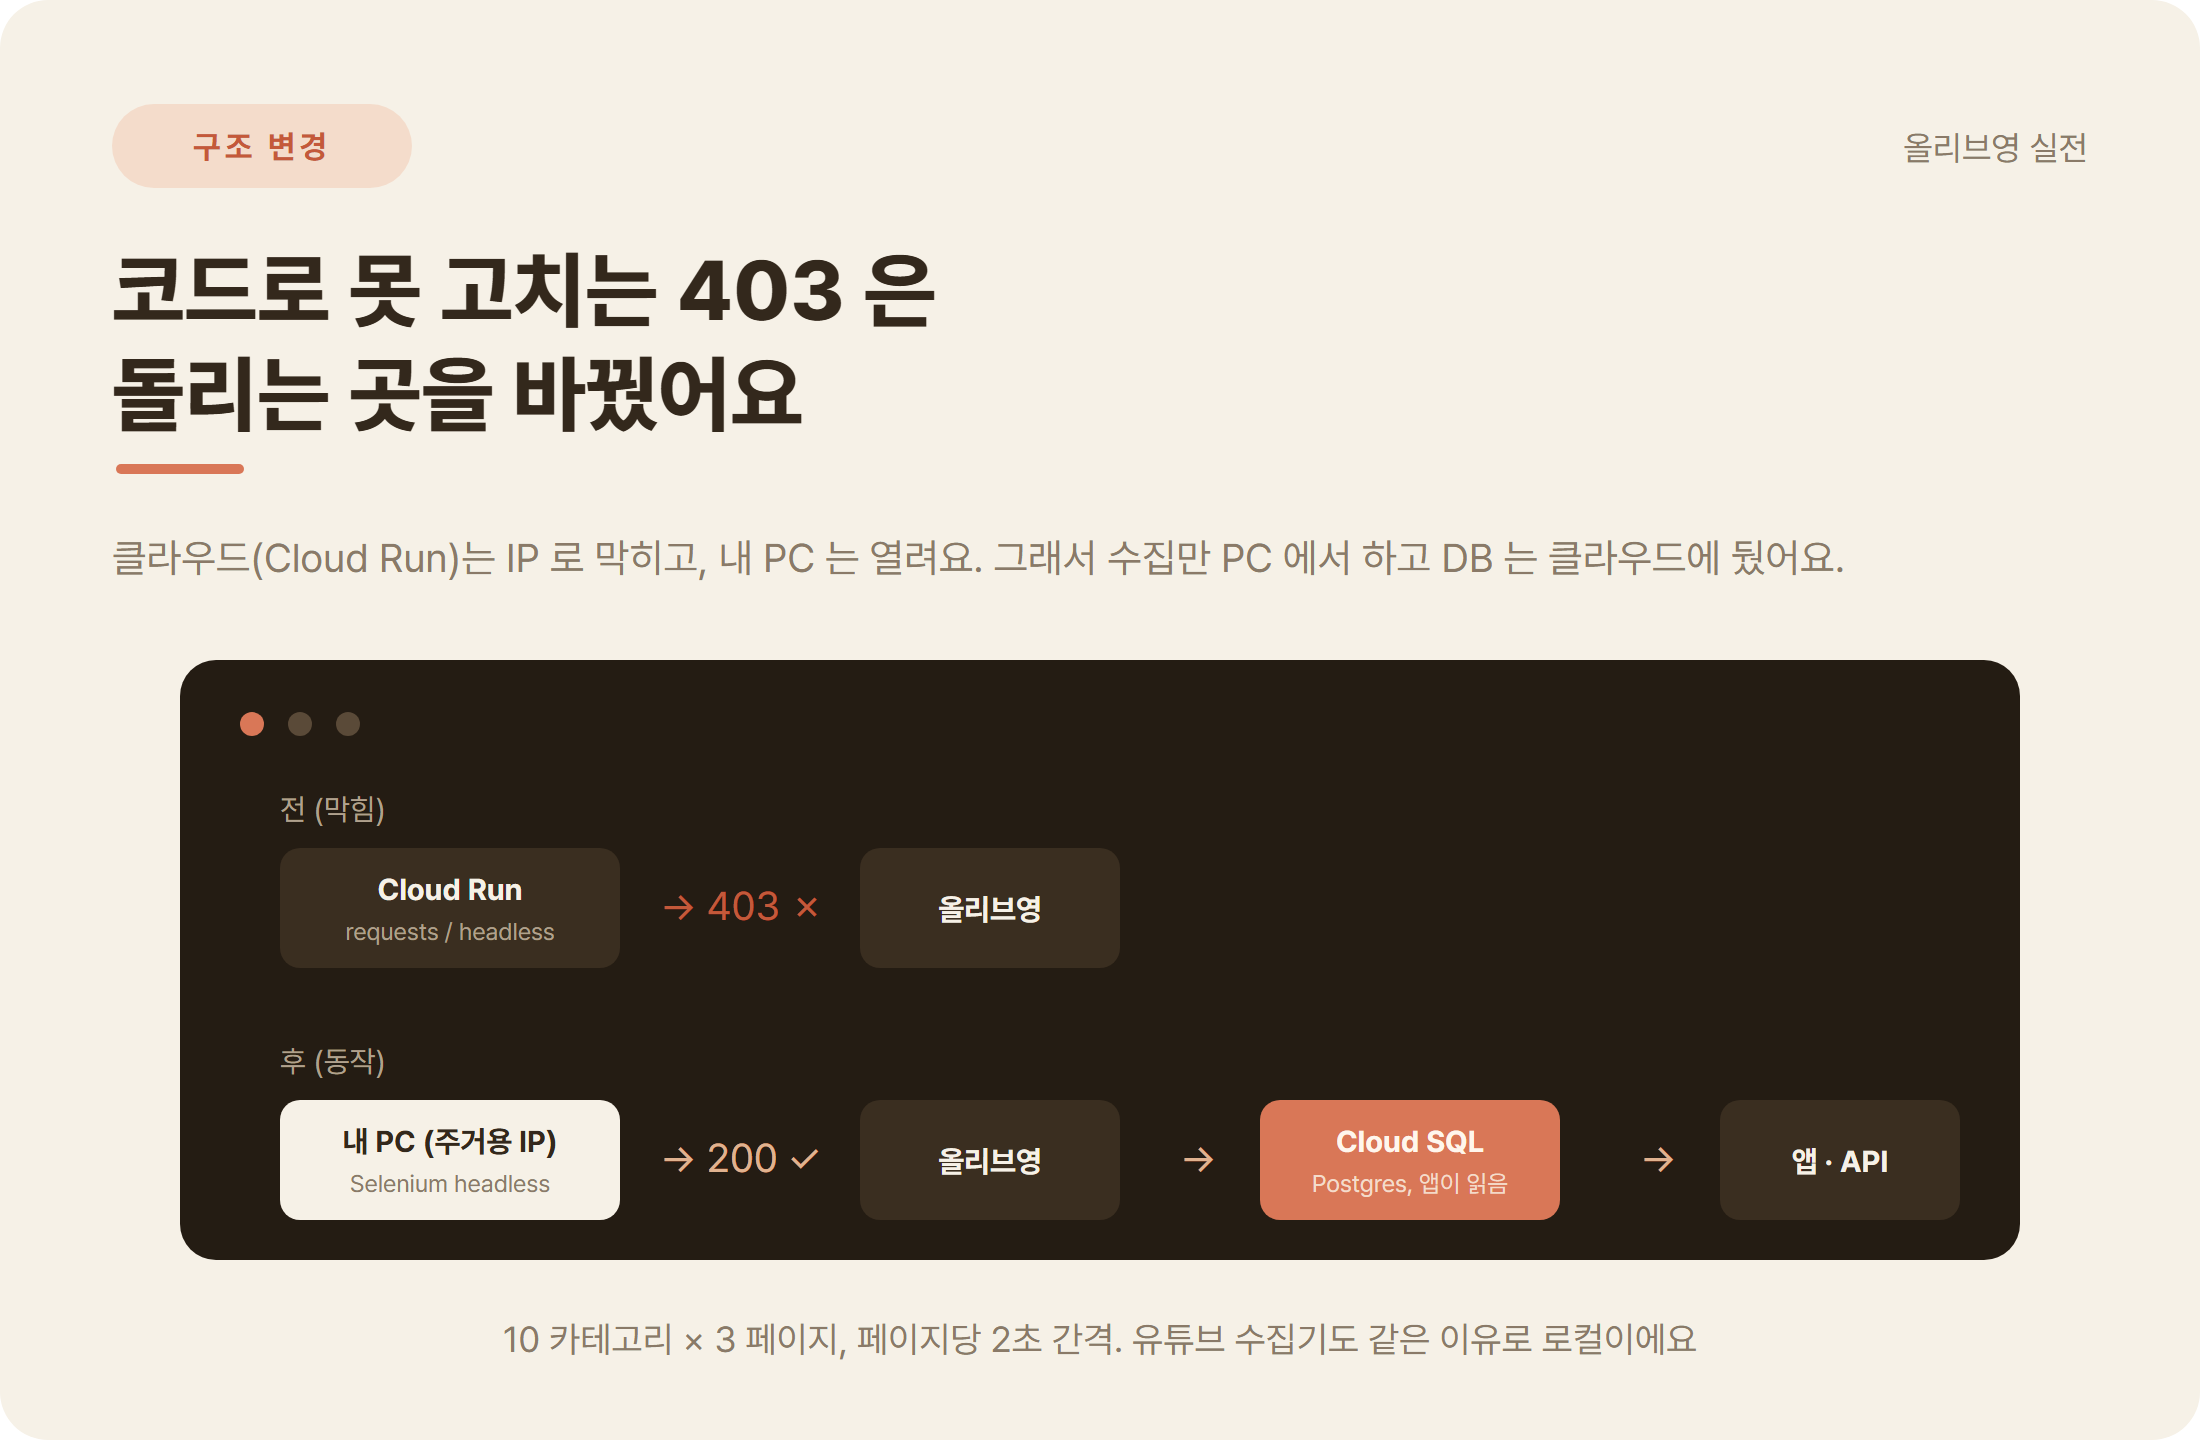
COSMO 수집기가 두 번째로 맞은 403 이 이거예요. 2026년 4월, 로컬에서 정상 동작하던 Selenium 수집기를 Cloud Run 에 배포하자 코드 변경 없이 다시 403 이 나왔어요. 원인은 IP 였어요. 올리브영이 데이터센터 IP 대역을 차단하고 있어서 헤더도 브라우저도 소용없었어요.
그래서 실행 위치를 바꿨어요.
- 수집: 주거용 IP 인 로컬 PC 에서 실행해요. Windows 작업 스케줄러로 하루 1회, 10개 카테고리 × 3페이지, 페이지당 2초 간격이에요.
- 저장: 결과를 Cloud SQL(PostgreSQL) 에 직접 써요. 로컬 IP 를 DB 의 authorized networks 에 등록하면 돼요.
- 앱·API: Cloud Run 에 그대로 두고 DB 만 읽어요. 403 과 무관해요.
같은 프로젝트의 유튜브 리뷰 수집기도 동일한 이유로 로컬에서 돌아요. 클라우드에서 실행하면 “Sign in to confirm you’re not a bot” 이 떠요. 자세한 구조는 유튜브 리뷰 수집기 로컬 실행 편에, 수집기가 속한 앱 전체는 COSMO 구현기에 있어요.
갈래 ⑤ 해결: 요청 간격과 지수 백오프 재시도
# 갈래 5 해결 : 간격 + 재시도 (403 이 속도 제한일 때)
import time, random, requests

def get_with_retry(session, url, tries=4):
    for i in range(tries):
        r = session.get(url, timeout=10)
        if r.status_code in (403, 429, 503):
            wait = int(r.headers.get("Retry-After", 0)) or (2 ** i + random.random())
            print(f"[{r.status_code}] {wait:.1f}s 대기 후 재시도 {i+1}/{tries}")
            time.sleep(wait)                  # 1 → 2 → 4 → 8초 + 지터
            continue
        r.raise_for_status()
        return r
    raise RuntimeError(f"포기: {url}")

# 그리고 요청 사이에 항상 쉬어요
time.sleep(random.uniform(1.5, 3.0))

# 4번 다 403 이면 속도가 아니라 IP·봇 감지예요. 더 세게 두드리면 차단만 길어져요
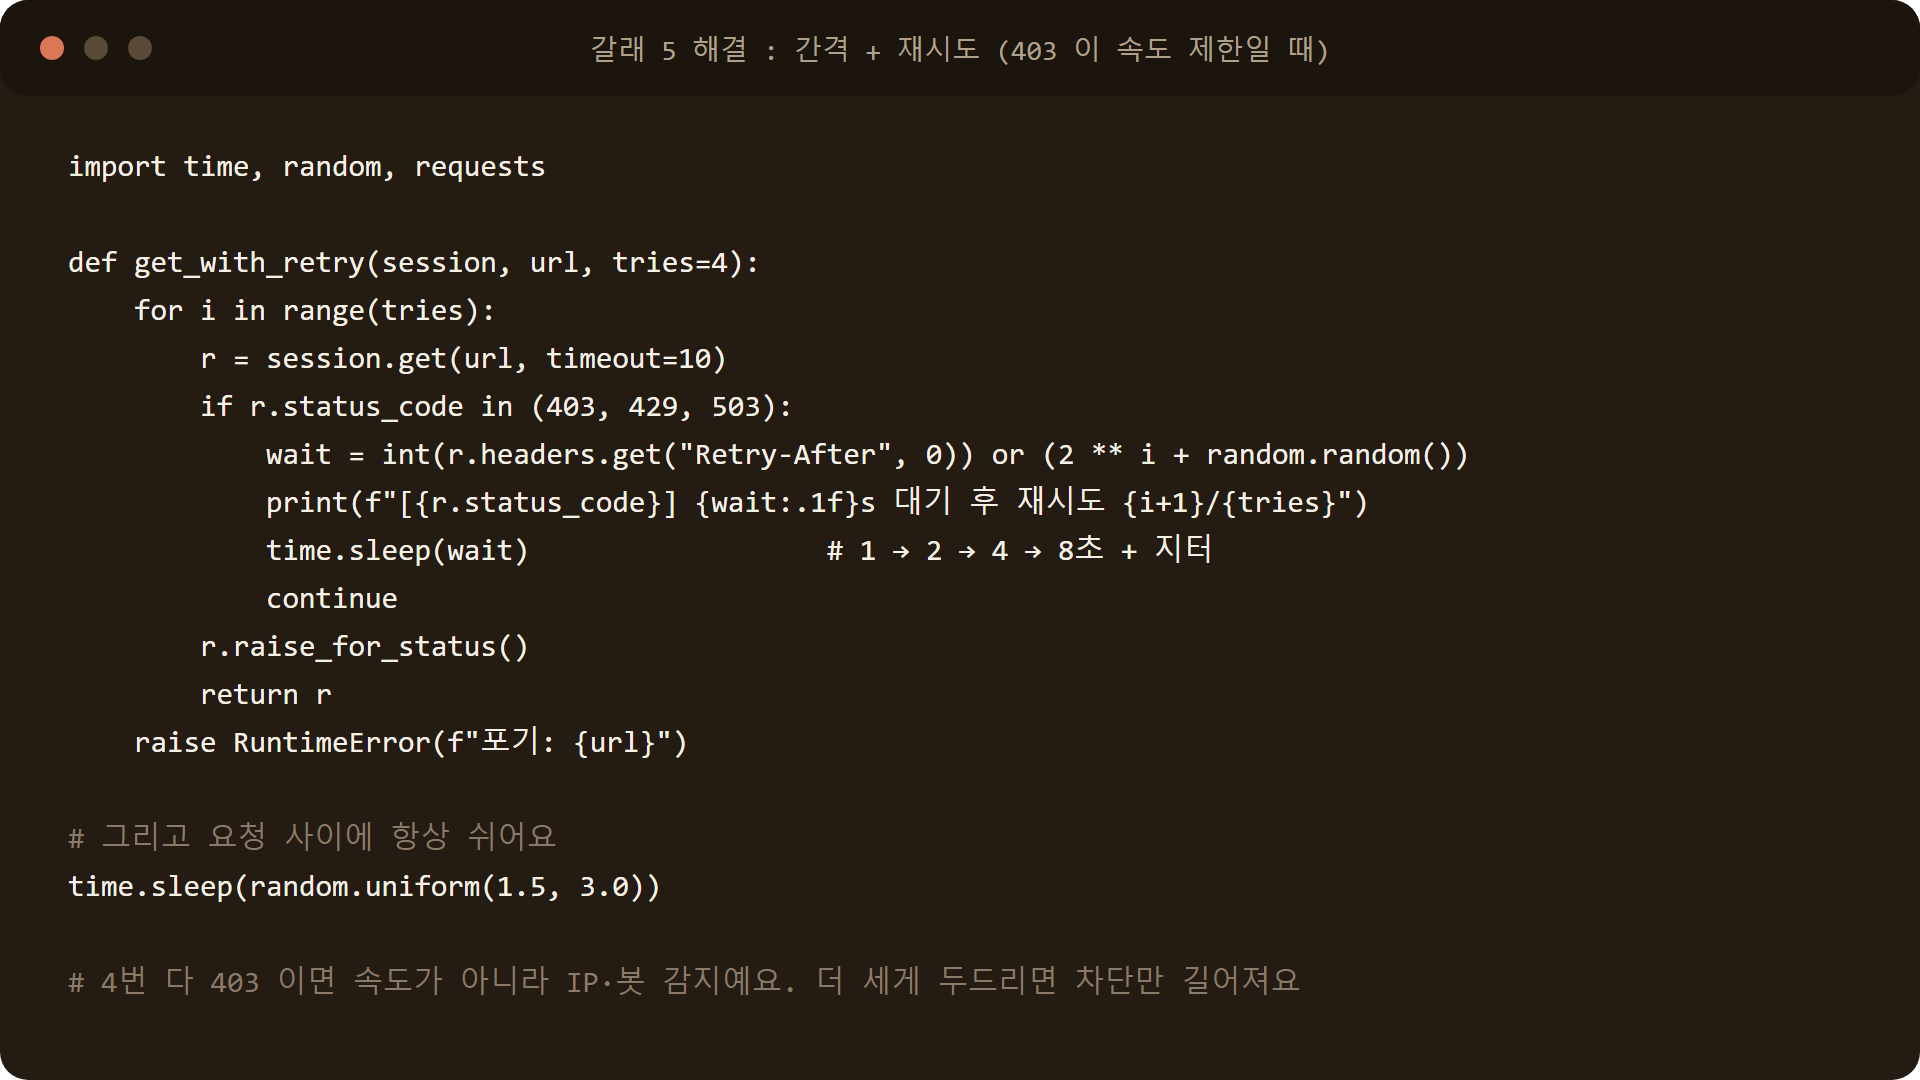
처음 몇 번은 200 이다가 403 으로 바뀌면 속도 제한이에요. 요청 사이에 1.5~3초 쉬고, 403·429·503 을 받으면 1초, 2초, 4초, 8초로 늘려가며 최대 4회 재시도해요. 응답에 Retry-After 헤더가 있으면 그 값을 우선해요.
4회 모두 403 이면 속도 문제가 아니에요. ③ 이나 ④ 로 돌아가세요. 더 자주 두드리면 차단 기간만 길어져요.
크롤링 403 을 뚫기 전에 지키는 선 3가지
- robots.txt 와 이용약관을 먼저 확인해요. 명시적으로 금지한 경로는 수집하지 않고, 공식 API 가 있으면 그것을 우선해요.
- 사람이 보는 속도로만 요청해요. 페이지당 2초, 카테고리당 3페이지, 하루 1회예요. 서버에 부담을 주는 순간 상대가 차단할 이유가 생겨요.
- IP 우회 서비스는 쓰지 않아요. 주거용 프록시로 ④ 를 넘길 수는 있지만 그 시점부터 “차단을 우회했다”는 기록이 남아요. COSMO 는 로컬 실행으로 충분했어요.
자주 묻는 질문
Q. User-Agent 만 바꾸면 403 이 해결되나요?
갈래 ① 일 때만 해결돼요. 안 되면 Accept-Language 와 Referer 까지 세트로 넣고, 그래도 403 이면 헤더 문제가 아니에요. curl 진단 2단계에서 갈려요.
Q. Selenium 과 Playwright 중 무엇을 쓰나요?
둘 다 갈래 ③ 을 해결해요. COSMO 수집기는 Selenium + webdriver-manager, 블로그 자동화는 Playwright 를 써요. 새로 시작한다면 Playwright 가 설치와 대기 처리가 간단해요.
Q. 클라우드에서 꼭 실행해야 하는데 IP 로 차단되면 어떻게 하나요?
수집 단계만 분리해 로컬이나 다른 환경에서 실행하고 결과만 클라우드 DB 에 올리는 구조가 가장 깔끔해요. 프록시 우회는 약관과 비용 문제가 함께 오므로 마지막 선택지예요.
Q. 403 과 401 은 무엇이 다른가요?
401 은 “인증이 필요하다”, 403 은 “식별했지만 허용하지 않는다” 예요. 401 이면 인증 헤더나 로그인 쿠키를 확인하고, 403 이면 위 5갈래를 순서대로 진단해요.
Q. 클로드코드(Claude Code)에 403 을 고쳐달라고 하면 되나요?
에러 문구와 curl 결과, “내 PC 에서는 되고 클라우드에서는 안 된다” 같은 사실을 함께 주면 갈래를 정확히 골라요. 문구만 주면 헤더부터 바꾸자고 제안하는데 그건 ① 일 때만 맞아요. 진단 정보가 먼저예요.
함께 보면 좋은 글
출처: MDN 403 Forbidden, Cloudflare Challenges 문서, Python requests Session Objects, Selenium Chrome 문서. 올리브영 수집기 코드는 2026년 4월 작성본이며 2026년 9월 17일 현재 같은 구조로 동작해요. 사이트 차단 정책은 예고 없이 바뀌므로 다시 막히면 진단 순서부터 타세요.
Leave a Reply