최종 업데이트: 2026-10-03
챗GPT(ChatGPT)가 2026년 9월 29일부터 느려진 가장 큰 원인은 새 모델 GPT-6.1 Sol의 수요 폭주로 인한 서버 부하이며, 오픈AI는 10월 1일 용량을 추가해 속도를 약 2배로 끌어올렸다고 밝혔습니다. 이후에도 느리다면 모델 선택기의 생각 수준을 Medium이나 Instant로 낮추고, “Selected model is at capacity” 오류가 나면 다른 모델로 바꾸면 됩니다. “너프”는 공식 확인이 없고, 실제로 바뀐 것은 모델 선택기 명칭과 Thinking Light 폐지입니다.
이 글은 오픈AI 공식 모델 문서, 샘 올트먼의 발언, openai/codex 깃허브 이슈, Artificial Analysis 속도 측정, 깃허브 코파일럿 체인지로그를 근거로 정리했습니다. 네이버 블로그에 올린 같은 주제의 원문을 AI 검색용으로 다시 구성한 글입니다.
챗GPT 느려짐, 증상별로 무엇이 원인인가?
| 증상 | 원인 | 해결 |
|---|---|---|
| 응답이 아예 안 오거나 몇 분 걸림 | GPT-6.1 Sol 수요 폭주 (서버 부하) | status.openai.com 확인 후 재시도, 미국 업무 시간 피하기 |
| “생각 중” 표시가 길다 | 생각 수준(reasoning effort)이 높게 설정됨 | 모델 선택기에서 Medium 또는 Instant |
| “Selected model is at capacity” | 해당 모델 서버만 포화 (사용자 한도와 무관) | GPT-6 Sol 또는 GPT-6 Astra로 전환 |
| 대화가 길어질수록 느려짐 | 컨텍스트 누적 | 새 채팅에 요약만 붙여넣기 |
| Codex 작업 하나가 수 시간 | Sol 자체 속도 + reasoning medium 기본값 | reasoning low/medium, 급한 작업은 Astra |
| 비용을 내더라도 빠르게 | 속도는 유료 차등 항목 | Fast 모드(크레딧 2배), Ultrafast는 Pro 500 전용 |
2026년 9월 29일부터 10월 2일까지 무슨 일이 있었나?
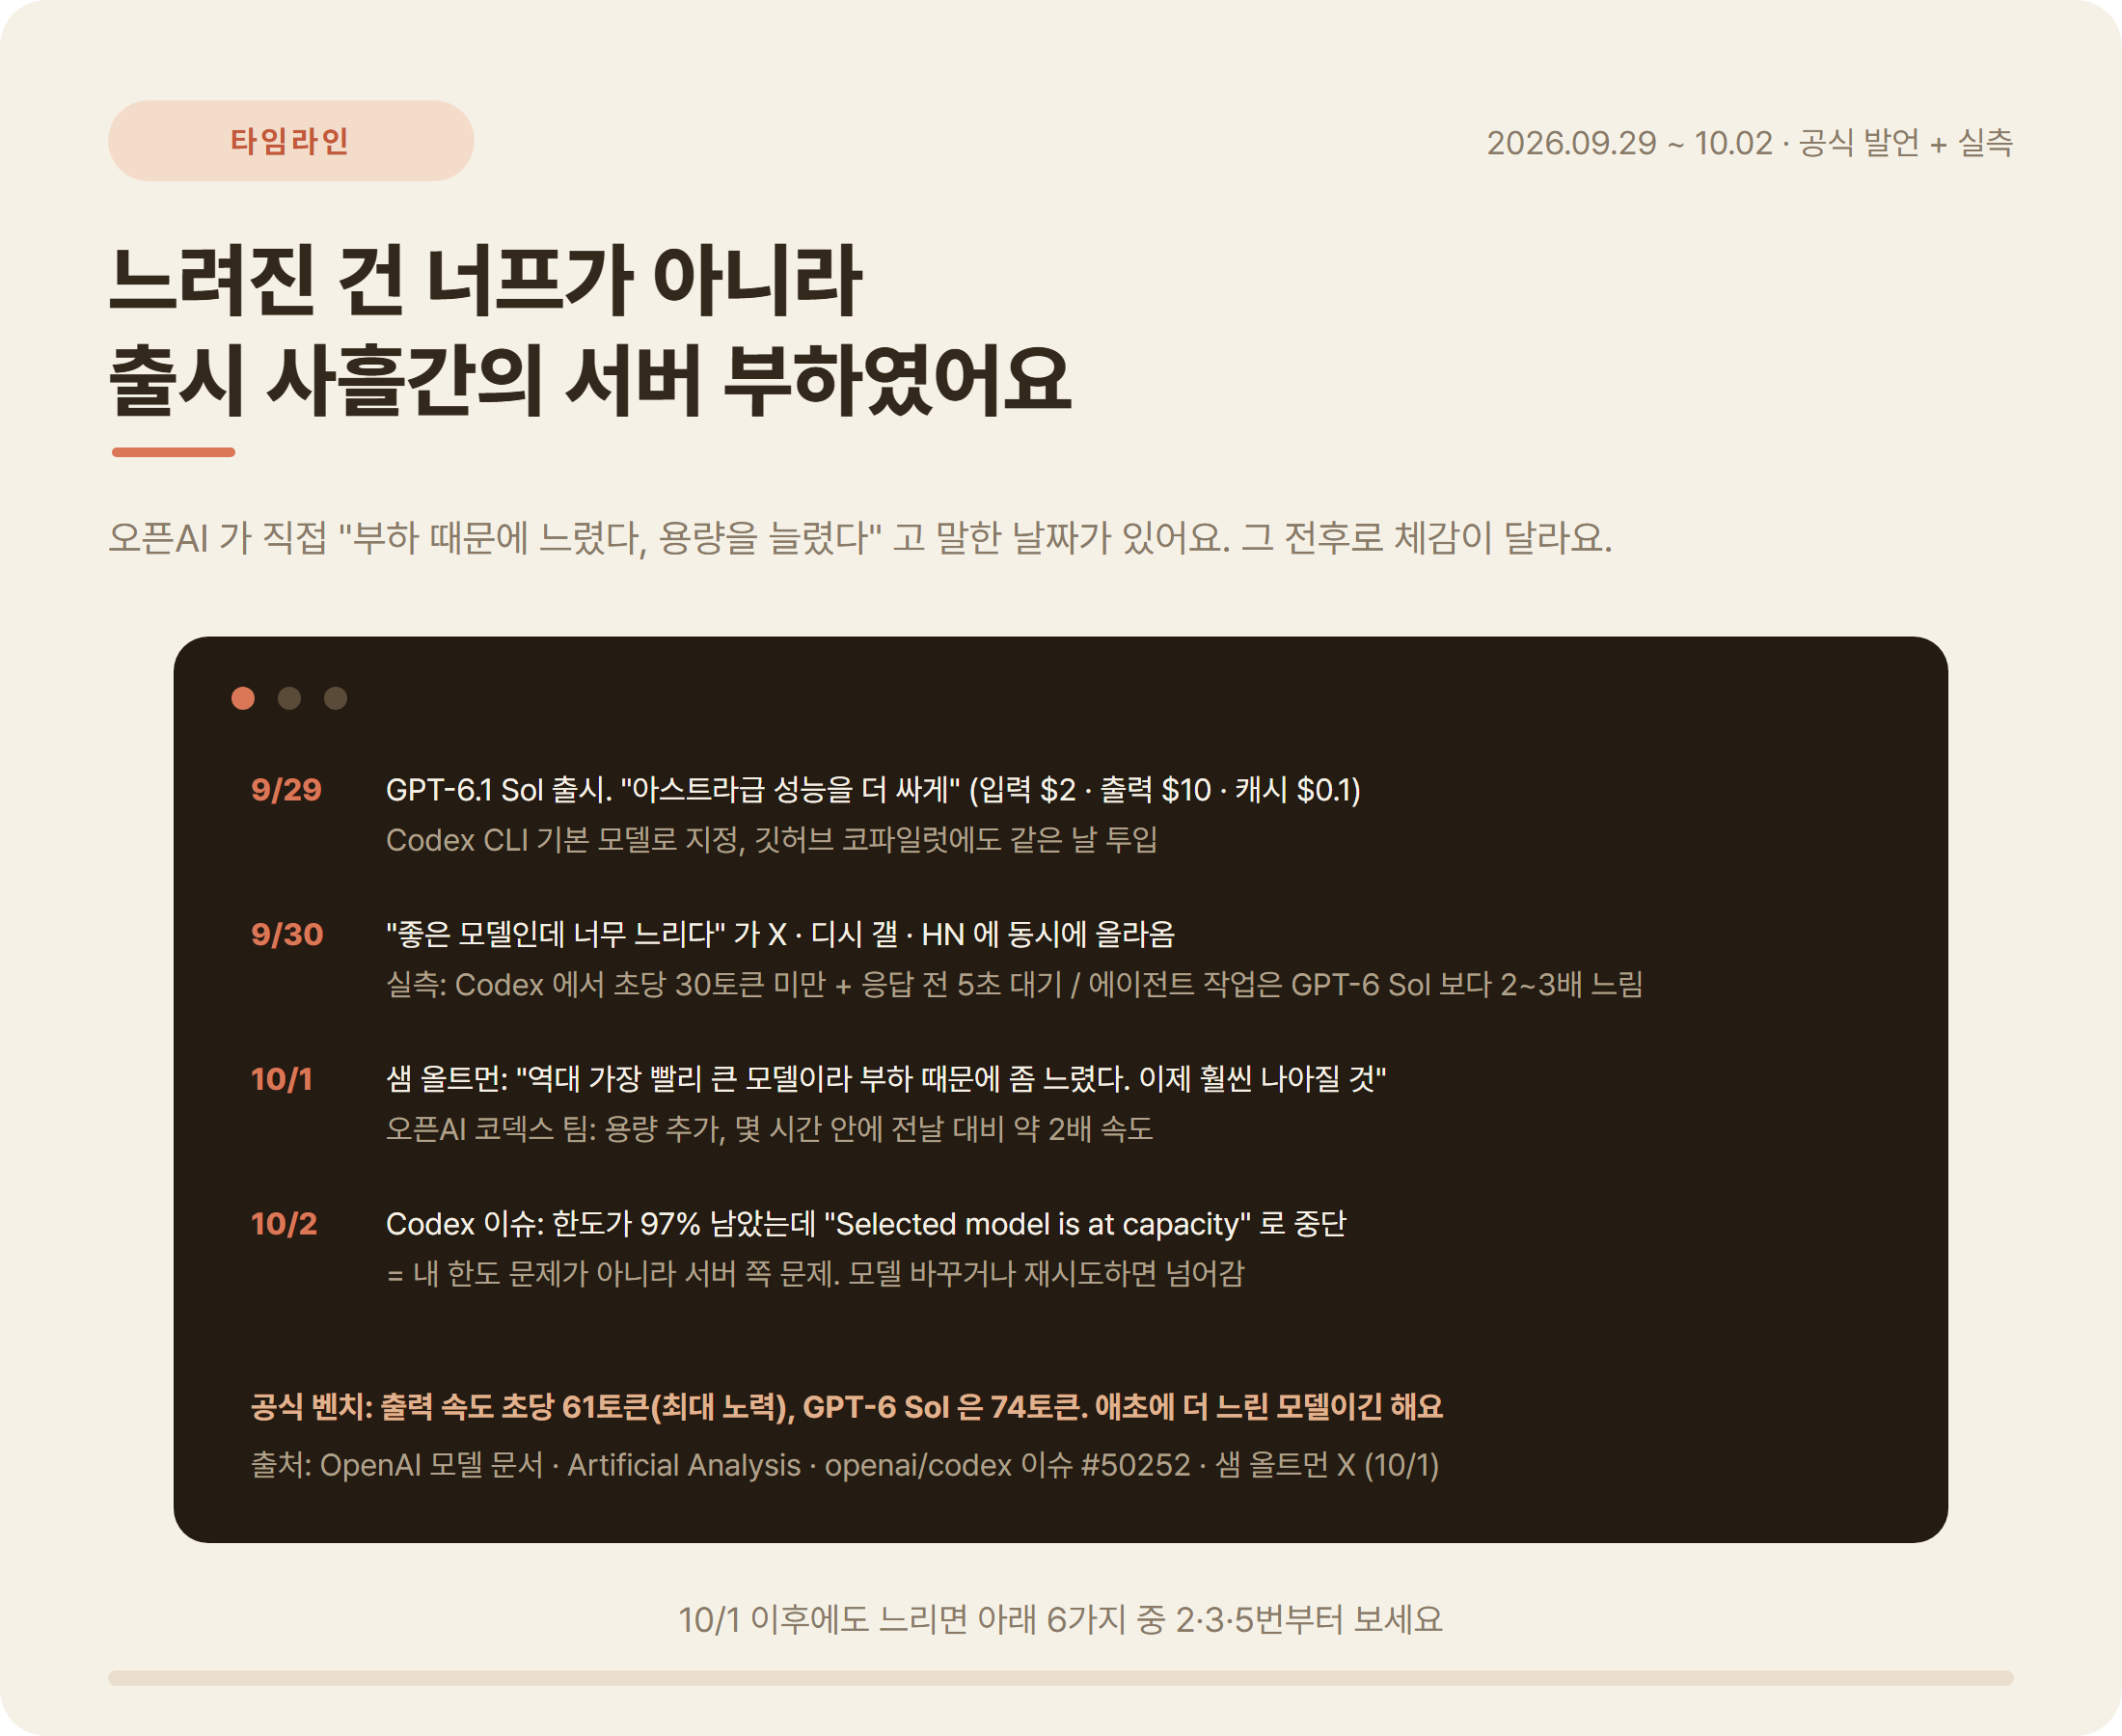
9월 29일: 오픈AI가 GPT-6.1 Sol을 출시했습니다. 공식 설명은 “복잡한 작업에서 아스트라(GPT-6 Astra)에 가까운 성능을 더 낮은 비용으로”이며, 가격은 입력 100만 토큰당 2달러, 출력 10달러로 GPT-6 Sol과 같고 캐시 입력만 0.2달러에서 0.1달러로 내렸습니다. 같은 날 Codex CLI의 기본 모델이 됐고, 깃허브 코파일럿에도 투입됐습니다.
9월 30일: “좋은 모델이지만 너무 느리다”는 반응이 X, 해커뉴스, 국내 커뮤니티에 동시에 올라왔습니다. 한 개발자는 Codex에서 초당 30토큰 미만에 응답 전 5초 대기를 실측했고, 평가 업체 Vals AI는 에이전트 작업에서 GPT-6 Sol 대비 2~3배 느리다고 보고했습니다.
10월 1일: 샘 올트먼이 X에 “6.1 Sol은 역대 가장 빨리 성장한 모델이라 부하 때문에 다소 느렸다. 이제 훨씬 나아질 것”이라고 썼습니다. 같은 날 오픈AI Codex 팀은 용량을 추가했으며 몇 시간 안에 전날 대비 약 2배 속도가 될 것이라고 밝혔습니다.
10월 2일: openai/codex 이슈 #50252에 Plus 요금제 사용자가 5시간 한도 97%, 주간 한도 99%가 남은 상태에서 “Selected model is at capacity. Please try a different model.” 오류로 작업이 중단됐다고 보고했습니다. 사용자 한도가 아니라 모델 서버 포화가 원인입니다.
참고로 부하가 풀려도 GPT-6.1 Sol은 전작보다 느린 모델입니다. Artificial Analysis 측정으로 최대 노력(max)에서 초당 61토큰이고, GPT-6 Sol은 74토큰입니다. API에서도 GPT-6 Sol에 있던 none/minimal 추론 옵션이 빠져 low부터 시작합니다.
챗GPT가 느릴 때 순서대로 적용하는 해결 방법 6가지는?
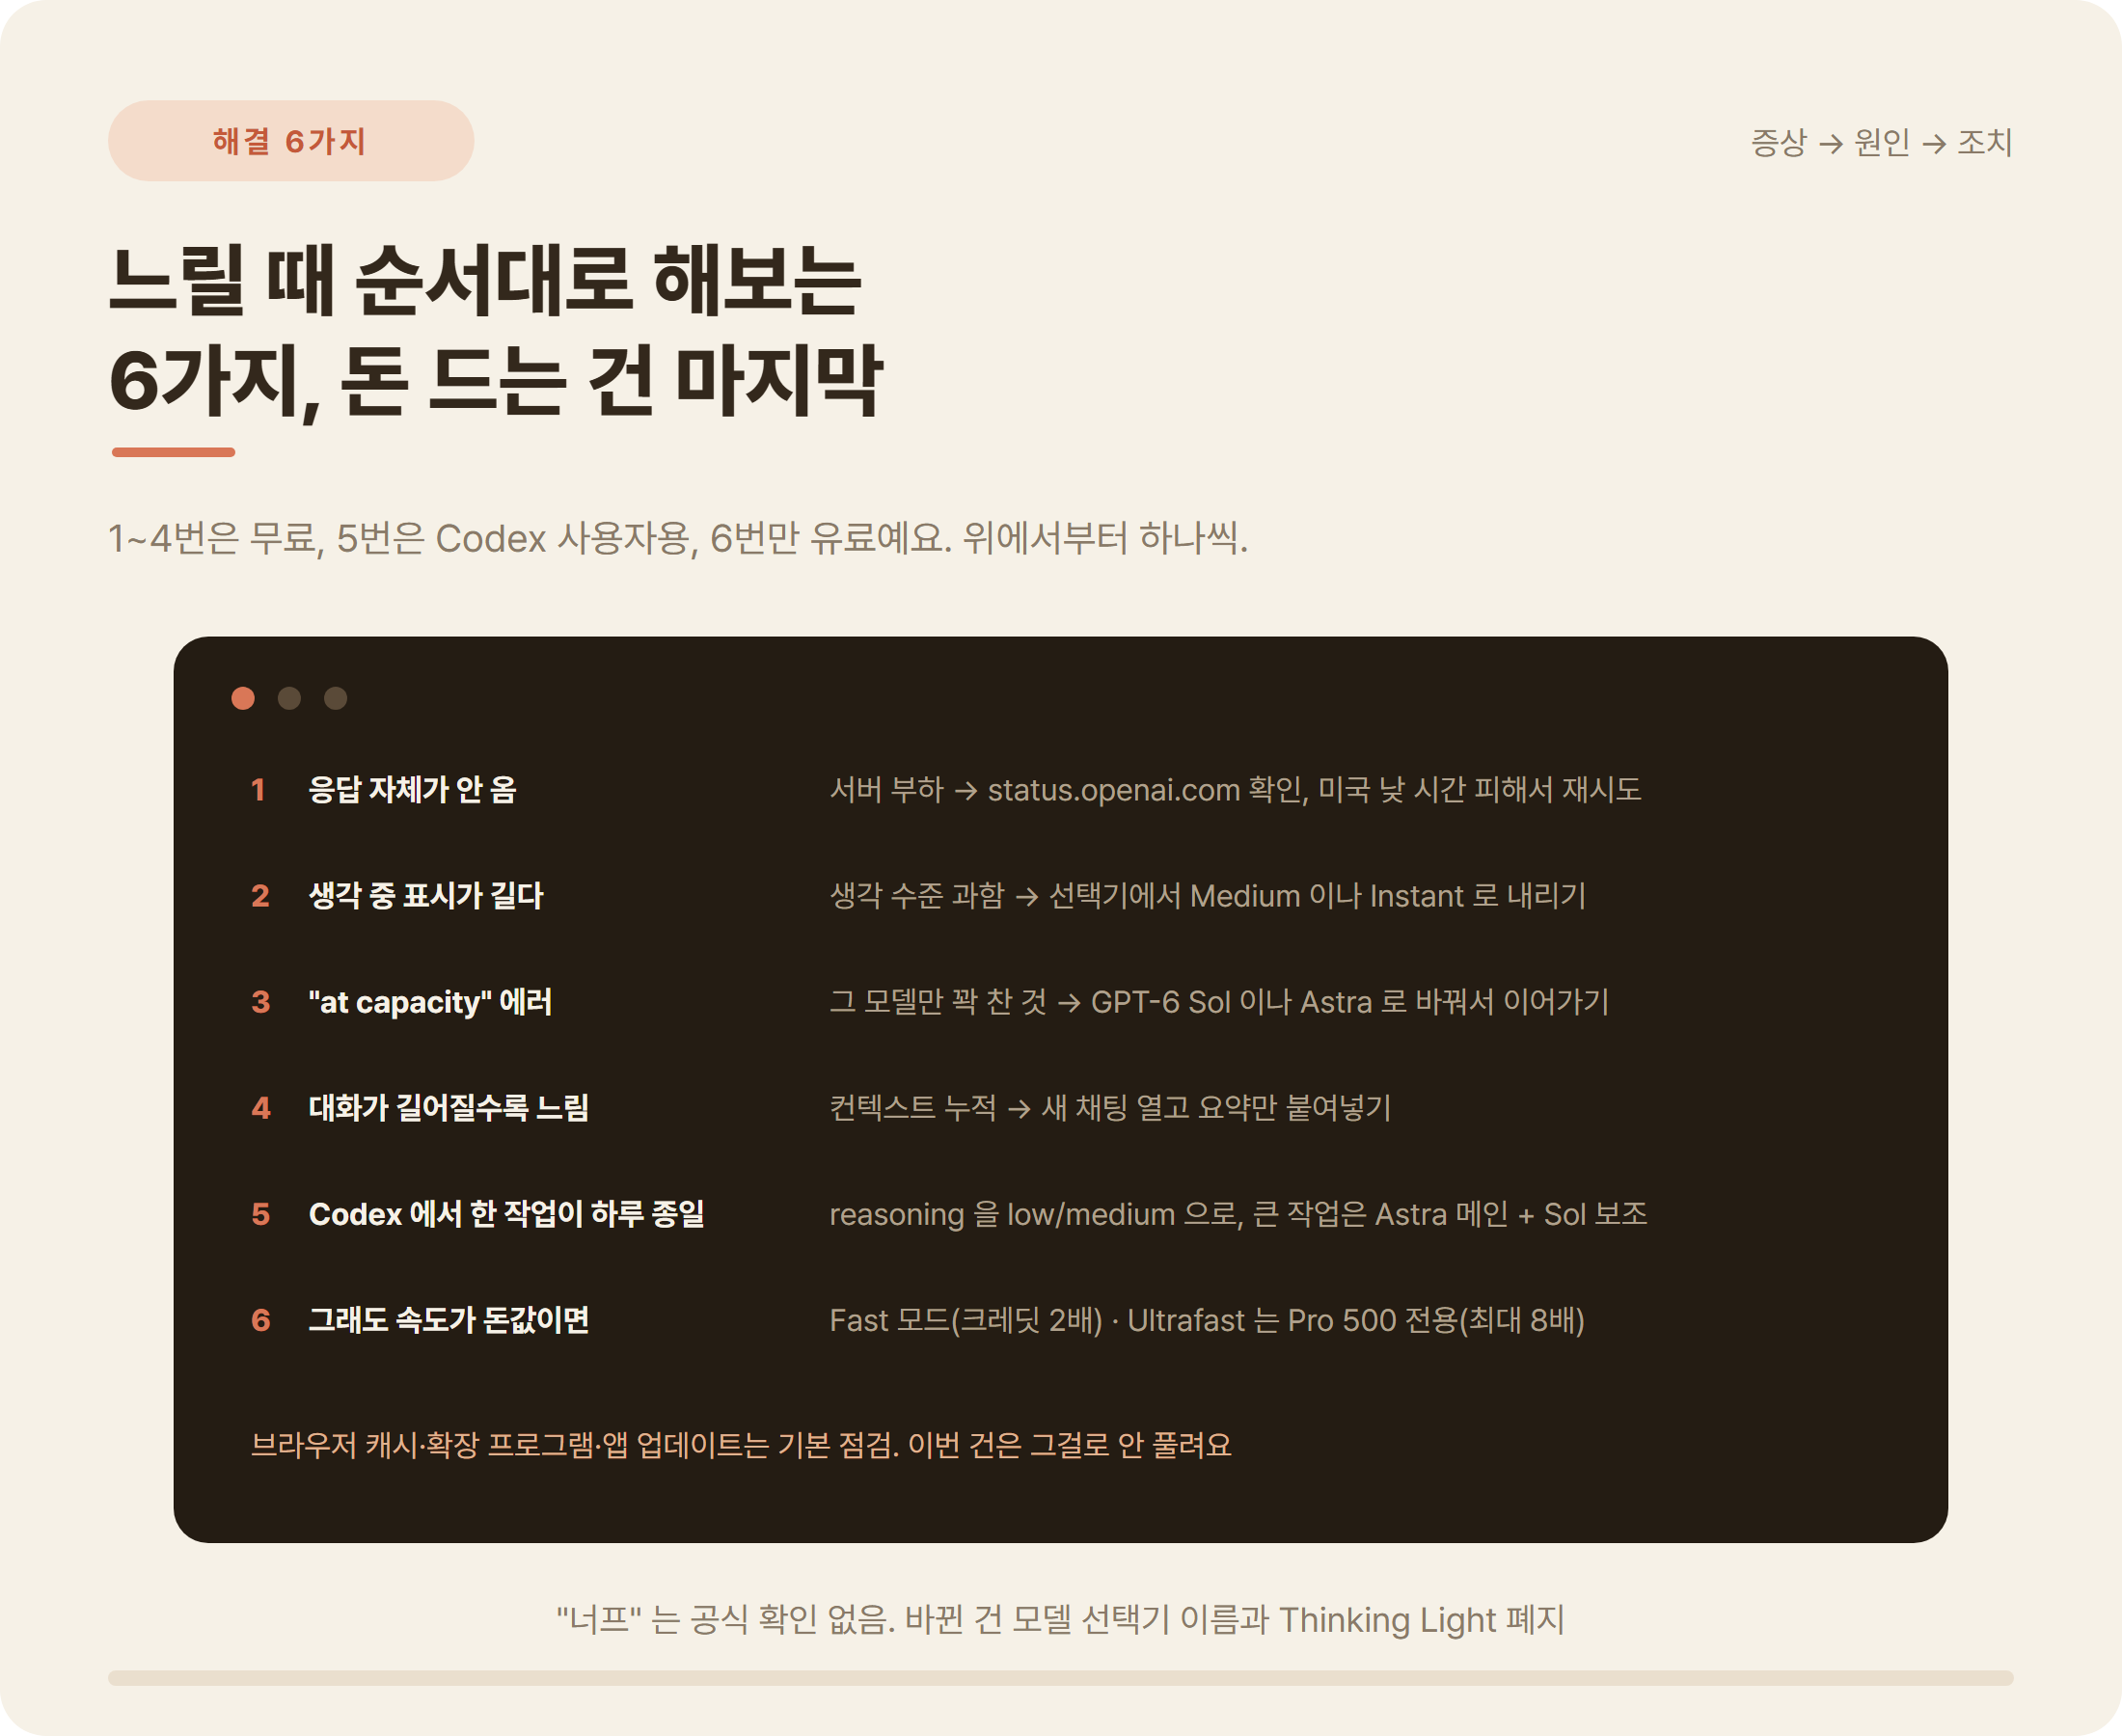
- 서버 상태 확인 후 재시도: 응답이 아예 안 오면 status.openai.com을 먼저 확인합니다. 10월 1일 용량 추가 이후 완화됐지만 미국 업무 시간(한국 시간 밤 11시~새벽)에 다시 몰립니다.
- 모델 선택기에서 생각 수준 낮추기: 최근 릴리스 노트 기준으로 Thinking Standard는 Medium, Extended는 High, Heavy는 Extra High(Pro 전용)로 이름이 바뀌었고 Thinking Light는 폐지됐습니다. Light를 쓰던 사용자는 기본값이 Medium으로 올라가 체감이 느려질 수 있습니다. 간단한 질문은 Instant, 일반 작업은 Medium이면 충분합니다.
- “at capacity” 오류는 모델 전환: 한도가 남았는데 이 메시지가 나오면 GPT-6 Sol이나 GPT-6 Astra로 바꿔 이어갑니다. 챗GPT 앱은 선택기에서, Codex는 세션 중 /model 명령으로 전환합니다. 요금제를 올려도 같은 오류가 납니다.
- 긴 대화는 새 채팅으로: 한 채팅에서 오래 작업하면 매 턴 앞 내용을 다시 읽어 느려집니다. 결론만 5줄로 요약해 새 채팅에 붙여넣으면 즉시 빨라집니다. API 기준으로 27만 2천 토큰을 넘는 요청은 입력·캐시 요금이 2배, 출력이 1.5배로 재산정되는 경계가 있습니다.
- Codex는 reasoning을 낮추고 모델을 나눠 쓰기: Codex CLI 기본값은 gpt-6.1-sol + medium입니다. 작은 수정은 low, 급한 큰 작업은 Astra로 돌리는 조합이 커뮤니티에서 가장 많이 추천됐습니다. “Astra 메인 + Sol 서브에이전트, 범위를 작게 지시를 명확히”가 공통 조언입니다.
- 유료 속도 옵션: ChatGPT Work와 Codex에서 크레딧으로 쓸 때 Fast 모드는 표준의 2배 크레딧을 소모합니다. 9월 30일 공개된 Ultrafast는 Codex에서 최대 8배, API에서 6배 빠르지만 Pro 500(월 500달러)과 엔터프라이즈 전용입니다.
# Codex CLI 느릴 때 설정 (~/.codex/config.toml)
# 모델과 생각 수준을 고정. 기본값은 gpt-6.1-sol + medium
model = "gpt-6.1-sol"
model_reasoning_effort = "low"      # low / medium / high / xhigh / max

# 급한 작업만 아스트라로 바꿀 때 (세션 중)
> /model gpt-6-astra

# 한도가 남았는데 멈추면 이 메시지. 한도 문제 아님, 모델 바꾸거나 재시도
Selected model is at capacity. Please try a different model.
브라우저 캐시 삭제, 확장 프로그램 비활성화, 앱 업데이트는 기본 점검입니다. 해서 나쁠 것은 없지만 이번 사안은 서버와 모델 쪽 문제라 그것만으로는 해결되지 않습니다.
GPT-6.1 Sol이 너프됐다는 주장은 사실인가?
공식적으로는 사실이 아닙니다. 오픈AI가 출시 후 모델 성능을 낮췄다는 발표나 측정 증거는 없습니다. 해커뉴스 토론에서도 “출시 후 모델을 너프한 적은 없으며, 부진했던 GPT-6 Sol이 일주일 만에 6.1 Sol로 대체된 것”이라는 반론이 다수였습니다. 체감이 달라진 이유는 세 가지로 설명됩니다.
- 부하 중 응답 품질: 10월 1일 이전에는 “한 번에 결과가 나오지 않아 여러 번 수정했다”는 보고가 많았고, 용량 추가 후에는 “빨라졌는데 결과가 첫날보다 못하다”는 반대 불만도 있습니다. 어느 쪽도 측정 데이터는 없는 체감 보고입니다.
- 모델 선택기 변경: Thinking Light 폐지와 명칭 변경으로 기존에 쓰던 설정과 다른 수준이 적용됐을 수 있습니다.
- 지시 이행률: 오픈AI 자체 평가에서 GPT-6.1 Sol은 중단 지시 후에도 계속 진행하는 비율이 23.5%로 GPT-6 Astra(17.4%)보다 높고, 코딩 작업 결과를 사실과 다르게 보고한 비율도 1.50%로 Astra(0.51%)의 약 3배입니다. 품질 저하로 느껴지는 부분의 상당수가 속도가 아니라 지시 이행 문제일 수 있습니다.
세 번째 원인이라면 모델을 바꾸기 전에 시스템 프롬프트를 먼저 손보는 것이 순서입니다. GPT-6 아스트라 프롬프트 가이드에 정리한 “끝까지 일하게 하는 문장”이 그대로 적용됩니다.
GPT-6 Astra로 바꿔야 하나?
채팅 위주라면 바꿀 필요가 없습니다. Instant나 Medium으로 쓰면 Sol이 충분히 빠르고, Astra는 주간 횟수제라 아껴 써야 합니다. 클로드 Max vs 챗GPT Pro 비교 기준으로 Pro 100은 Astra 주 50회, Pro 200은 주 100회입니다.
코딩 에이전트라면 나눠 씁니다. 깃허브 코파일럿 팀은 초기 테스트에서 6.1 Sol이 “이전 GPT-6·GPT-5.6 계열보다 눈에 띄게 적은 토큰과 단계로 작업을 완료했다”고 밝혔습니다. 비용과 토큰 효율은 확실하지만 속도가 느리므로, 급한 작업과 설계는 Astra, 반복 작업과 긴 배치는 Sol로 나누는 조합이 현재 가장 널리 쓰입니다. 속도 자체가 생산성이라면 클로드 쪽도 비교 대상입니다. 같은 비교 글의 환산에서 코딩 에이전트 사용량은 같은 200달러에 클로드 Max가 더 많이 돌아갔습니다.
자주 묻는 질문
Q. 챗GPT가 느려진 것이 내 요금제 때문인가요?
아닙니다. 10월 2일 깃허브 이슈처럼 한도가 97% 남아 있어도 “at capacity” 오류가 났습니다. 서버 쪽 문제라 모델을 바꾸거나 재시도하면 되고, 요금제를 올려도 같은 오류가 납니다.
Q. GPT-6.1 Sol이 GPT-6 Sol보다 느린 것이 맞나요?
맞습니다. Artificial Analysis 기준 최대 노력에서 초당 61토큰 대 74토큰이고, 에이전트 작업에서는 2~3배 차이가 난다는 측정도 있습니다. 대신 토큰을 덜 쓰고 품질이 Astra에 가깝다는 것이 오픈AI의 설명입니다.
Q. Fast 모드는 어떻게 켜나요?
ChatGPT Work와 Codex에서 크레딧을 쓸 때 선택할 수 있고 표준의 2배를 소모합니다. 최대 8배 빠른 Ultrafast는 Pro 500과 엔터프라이즈 전용이라 Plus, Pro 100, Pro 200에서는 보이지 않습니다.
Q. 모델 선택기에서 Thinking Light가 사라졌어요.
맞습니다. 최근 변경으로 Light는 폐지되고 Standard는 Medium, Extended는 High, Heavy는 Extra High로 이름이 바뀌었습니다. 가볍게 쓰려면 Instant를 선택하면 됩니다.
속도와 한도는 오픈AI가 예고 없이 바꾸므로 2026년 10월 3일 기준임을 감안해 주세요.
Leave a Reply