최종 업데이트: 2026-10-20
모델·하네스·토큰·임베딩은 각각 무슨 뜻인가요?
모델(Model)은 학습된 AI 본체이고, 하네스(Harness)는 그 모델을 실제로 일하게 만드는 바깥 실행 환경 전부예요. 토큰(Token)은 AI가 글을 읽고 쓰는 최소 조각이고, 임베딩(Embedding)은 글의 의미를 숫자 목록(벡터)으로 바꾼 거예요.
이 네 단어만 알면 “클로드코드가 좋다”, “토큰이 모자라다”, “임베딩 검색” 같은 말이 대부분 이해돼요. 아래 내용은 앤트로픽(Anthropic)·오픈AI(OpenAI)·구글 클라우드(Google Cloud) 공식 문서(2026-10-20 확인)를 기준으로 정리했고, 비유는 이해를 돕기 위한 것이에요.
4개 용어를 한 표로 비교하면?
| 용어 | 한 줄 뜻 | 비유 | 왜 중요한가 |
|---|---|---|---|
| 모델 (Model) | 학습된 AI 본체 (GPT, 클로드, 제미나이 등) | 요리사 | 답의 기본 실력을 정해요 |
| 하네스 (Harness) | 모델 바깥의 실행 환경 전부 | 주방과 조리도구 | 같은 모델도 성능이 달라져요 |
| 토큰 (Token) | AI가 글을 쪼개 읽는 최소 단위 | 재료를 썬 한 조각 | 요금·속도·기억 한도의 기준이에요 |
| 임베딩 (Embedding) | 의미를 숫자 목록으로 바꾼 것 | 맛 지도 위의 좌표 | 검색·추천·분류에 쓰여요 |
AI 모델(LLM)이란?
모델은 방대한 글을 학습해 다음에 올 말을 예측하는 AI 본체예요. 챗GPT(ChatGPT) 뒤의 GPT, 클로드(Claude), 제미나이(Gemini), GLM이 모두 모델 이름이에요.
흔히 말하는 LLM(Large Language Model, 대형 언어 모델)도 이 모델을 가리켜요. 앤트로픽 용어집은 LLM을 많은 파라미터를 가진 언어 모델로 설명하고, 클로드를 그 예로 들어요.
모델을 실력 좋은 요리사라고 보면 쉬워요. 다만 요리사 혼자서는 칼도 냉장고도 없으니, 실제로 요리하려면 주방이 필요해요. 그 주방이 하네스예요.
AI 하네스(Agent Harness)란? 클로드코드와는 어떤 관계인가요?
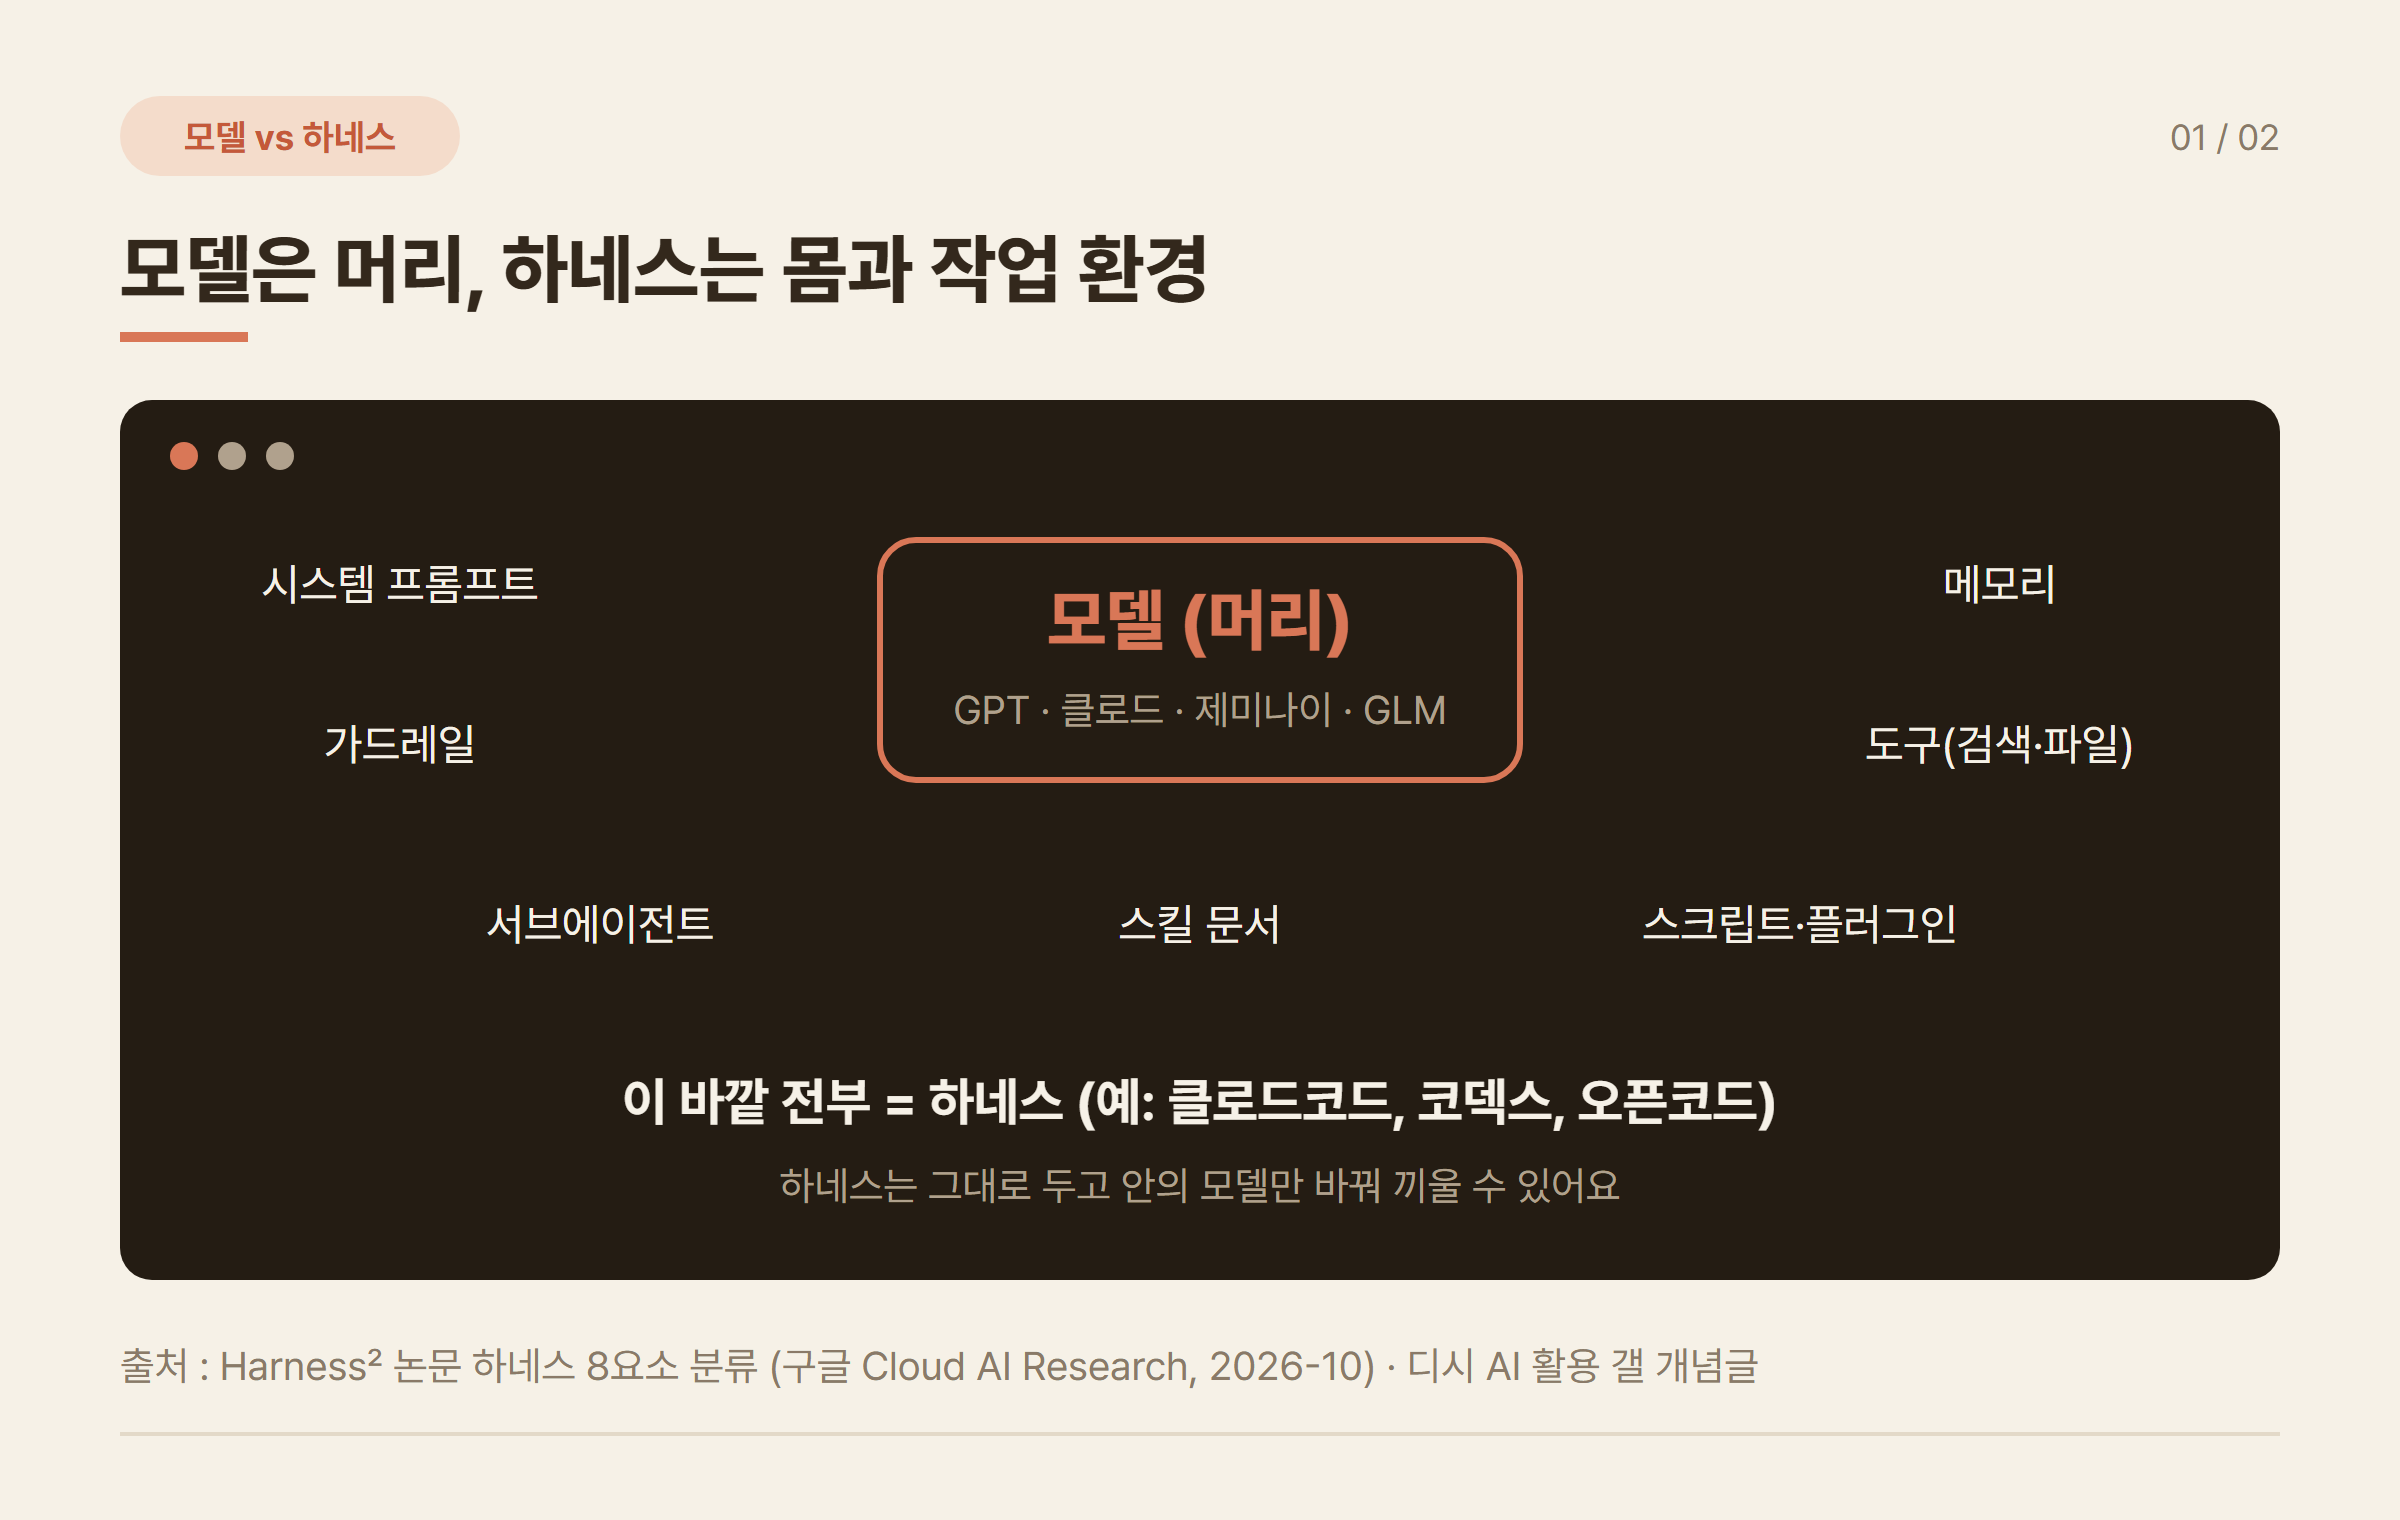
하네스는 모델을 뺀 나머지 전부예요. 원래 말에 채우는 마구(고삐·안장)를 뜻하는 단어로, 힘센 말(모델)을 원하는 방향으로 일하게 만드는 장치라는 의미예요.
하네스에는 보통 다음 요소가 들어가요.
- 시스템 프롬프트(System Prompt): AI에게 미리 주는 기본 지시
- 가드레일(Guardrail): 하면 안 되는 일을 막는 규칙
- 메모리(Memory): 이전 대화나 작업을 기억하는 장치
- 도구(Tools): 웹 검색, 파일 읽기·쓰기, 코드 실행
- 서브에이전트·스킬·스크립트: 일을 나눠 맡기거나 정해진 절차를 따르게 하는 장치
클로드코드(Claude Code), 코덱스(Codex), 오픈코드(OpenCode) 같은 코딩 도구가 대표적인 하네스예요. 그래서 같은 모델을 넣어도 어떤 하네스에서 돌리느냐에 따라 결과가 달라져요. 클로드코드의 실제 사용법은 클로드코드 사용방법에 정리해 두었어요.
2026년 10월 구글 Cloud AI Research 팀의 Harness² 논문(Recursive Agent Harnessing for an Open World)에서는 같은 제미나이 3.5 플래시 모델로 오픈코드가 79.9점, 코덱스가 71.6점을 받았어요. 모델은 그대로 두고 하네스 파일만 고치자 GLM-5 점수가 64.2에서 75.7로 올라, 수정하지 않은 제미나이(72.4)보다 높아졌다고 해요.
단, 이 점수는 논문 저자들이 직접 만든 벤치마크로 잰 값이고 구글 공식 제품 발표는 아니에요. “하네스도 성능을 크게 바꾼다” 정도로 받아들이면 충분해요.
토큰(Token)이란? 글자 수와 같은가요?
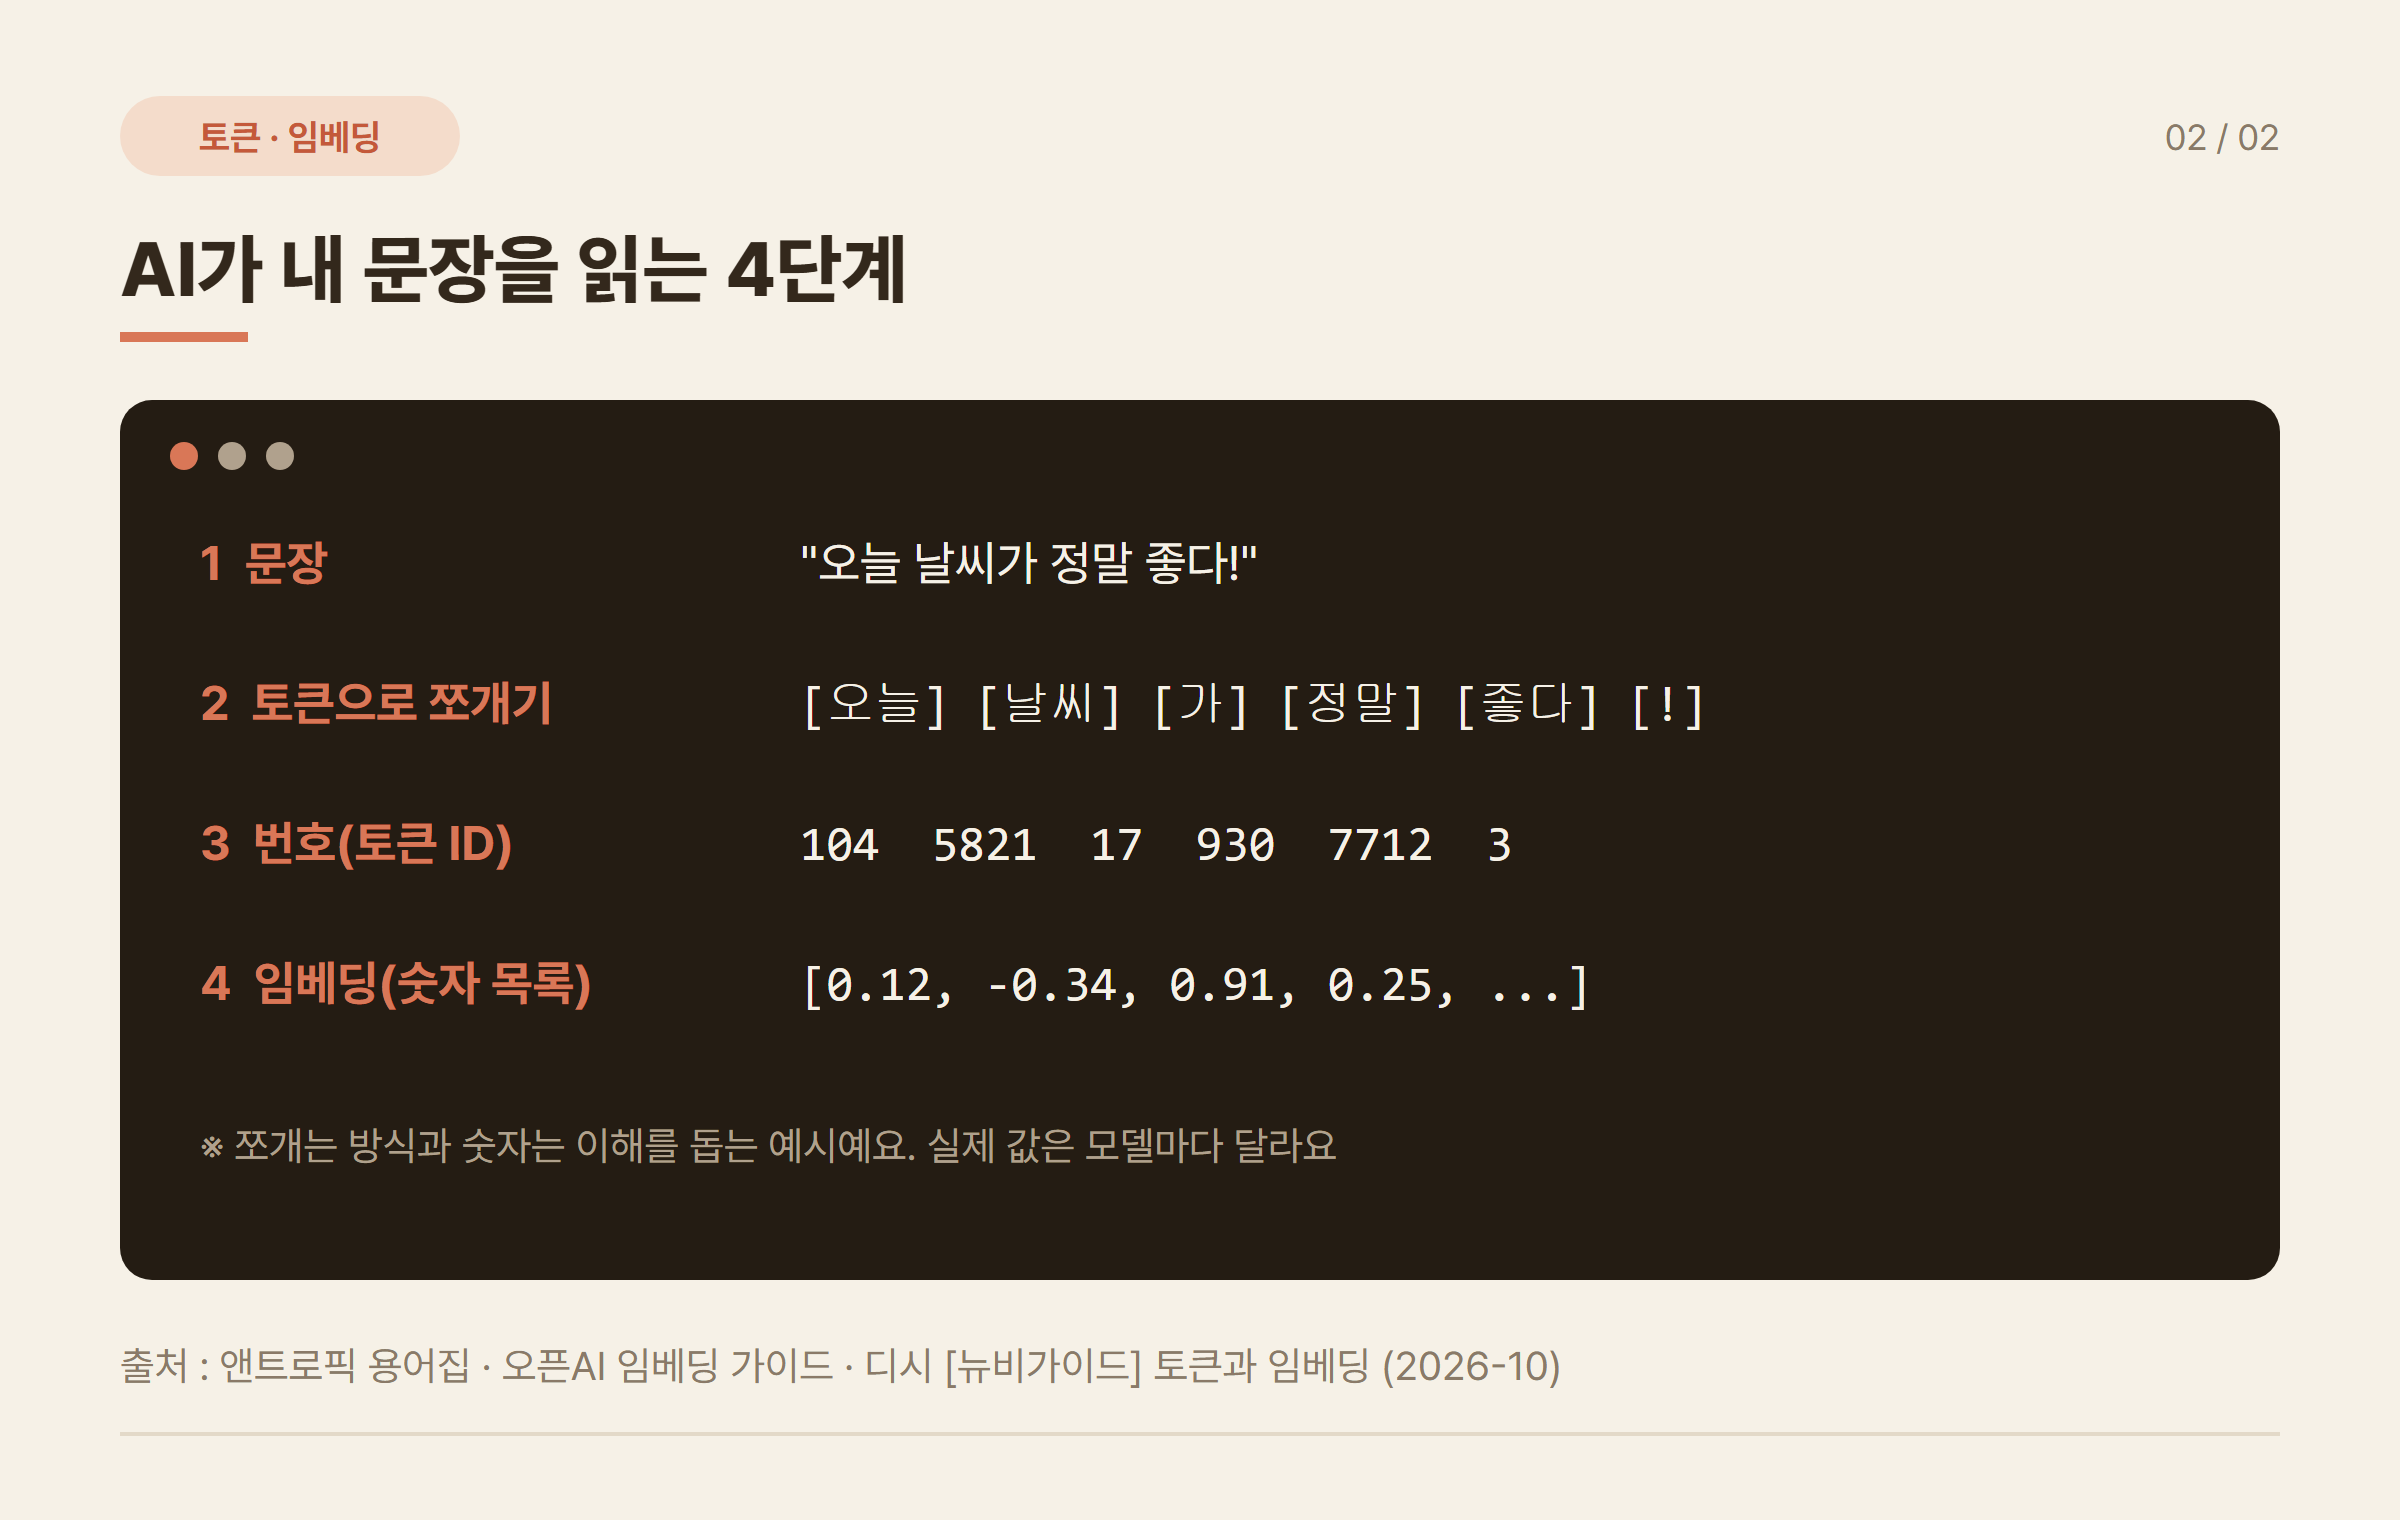
토큰은 AI가 글을 읽고 쓰는 가장 작은 조각이고, 글자 수나 단어 수와는 달라요. 단어 하나가 토큰 하나일 때도 있고, 여러 조각으로 나뉠 때도 있어요.
앤트로픽 용어집에 따르면 토큰은 단어, 단어 일부, 글자, 바이트 단위까지 될 수 있어요. 예전 클로드 모델은 영어 기준 대략 3.5글자가 토큰 1개였고, 클로드 4.7부터는 새 토크나이저(Tokenizer) 때문에 같은 글이 약 30% 더 많은 토큰이 돼요.
토큰이 중요한 이유는 세 가지예요.
- 요금: API 요금이 입력·출력 토큰 수로 매겨져요 (클로드코드 구독 vs API 비용 비교 참고)
- 기억 한도: 한 번에 볼 수 있는 양인 컨텍스트 윈도우(Context Window)가 토큰으로 정해져요
- 속도: 토큰이 많을수록 답이 늦게 나와요
컨텍스트 윈도우는 AI의 “작업 기억”이에요. 학습한 지식 전체가 아니라 지금 대화에서 한 번에 참고할 수 있는 양을 뜻해요. 정확한 토큰 수는 각 회사가 제공하는 토큰 세기(Token Counting) 기능으로 확인하는 게 가장 정확해요.
임베딩(Embedding)이란? 어디에 쓰이나요?
임베딩은 글의 의미를 숫자 목록(벡터, Vector)으로 바꾼 거예요. AI 안에서는 문장 → 토큰 → 토큰 번호(Token ID) → 임베딩 순서로 처리돼요.
토큰 번호 자체는 사전 번호일 뿐이라 의미가 없어요. 임베딩으로 바꿔야 “강아지”와 “개”는 가깝고, “강아지”와 “자동차”는 멀다는 걸 숫자 거리로 알 수 있어요.
오픈AI 임베딩 가이드는 임베딩을 소수점 숫자의 목록으로 설명하고, 두 임베딩 사이 거리가 가까울수록 관련성이 높다고 해요. 예를 들어 text-embedding-3-small은 숫자 1,536개, text-embedding-3-large는 3,072개로 문장 하나를 표현해요.
임베딩의 대표 용도는 이래요.
- 검색: 단어가 달라도 뜻이 비슷한 글 찾기
- 추천: 비슷한 상품·글 추천
- 분류·군집: 비슷한 글끼리 자동으로 묶기
- 이상 탐지: 혼자 동떨어진 데이터 찾기
“내 문서로 답하는 챗봇”, 즉 RAG(검색 증강 생성)도 문서를 임베딩으로 저장해 두고 질문과 가까운 문서를 찾아 모델에게 건네는 방식이에요. 내 PC에서 모델을 직접 돌려 보고 싶다면 로컬 LLM 무료 설치 방법도 함께 보면 좋아요.
자주 묻는 질문 (FAQ)
모델을 바꾸는 게 나은가요, 하네스를 바꾸는 게 나은가요?
둘 다 결과에 큰 영향을 줘요. 입문자라면 좋은 모델이 들어간 검증된 하네스(챗GPT 앱, 클로드코드 등)부터 쓰는 게 가장 편해요.
한글은 영어보다 토큰을 더 많이 쓰나요?
대체로 더 많이 써요. 토크나이저가 영어 위주로 만들어진 경우가 많아서 같은 내용도 한글이 더 잘게 쪼개지는 편이에요. 정확한 수는 모델마다 달라요.
토큰 한도(컨텍스트 윈도우)를 넘으면 어떻게 되나요?
앞부분을 잊거나 요청이 거절돼요. 긴 대화는 새 창에서 요약을 붙여 다시 시작하는 게 좋아요.
임베딩은 일반 사용자도 쓰나요?
직접 다룰 일은 적지만 이미 쓰고 있어요. 검색·추천·”내 파일로 답하기” 기능 뒤에서 임베딩이 동작해요.
에이전트와 하네스는 같은 말인가요?
같은 말은 아니에요. 에이전트(Agent)는 모델과 하네스가 합쳐져 스스로 일하는 것 전체이고, 하네스는 그중 모델을 뺀 틀이에요.
참고 자료
- Anthropic, Claude Docs Glossary
- OpenAI, Embeddings guide
- Google Cloud, What is an agent harness?
- Google Cloud AI Research, Harness²: Recursive Agent Harnessing for an Open World (2026-10) 및 wavect.io 리뷰
- 디시인사이드 AI 활용 갤러리 개념글 “개초보용 모델·하네스”, “[뉴비가이드] 토큰과 임베딩” (2026-10-19 확인)
Leave a Reply