최종 업데이트: 2026-09-09
클라우드 서버 IP로 유튜브에 요청하면 “Sign in to confirm you’re not a bot”으로 차단되고, 공식 YouTube Data API로 우회하면 하루 할당량 10,000 units 때문에 상품 99개가 한계예요. 그래서 화장품 커뮤니티 앱 코스모(COSMO)의 유튜브 리뷰 수집은 가정용 IP인 집 PC에서 yt-dlp로 검색하고 자막을 추출한 뒤 로컬 LLM(Ollama, EXAONE 3.5)으로 감성분석하고, 결과만 Cloud SQL에 저장해요. 이 글은 그 파이프라인의 실제 코드, 클라우드에서 받은 에러 원문 4가지, 트러블슈팅 5건을 정리한 기록이에요.
앱인토스 개발기 3편 출시 완료편에서 따로 다루겠다고 한 이야기예요. 클로드코드(Claude Code)와 함께 만든 파이프라인이고, 코드는 전부 실제로 실행 중인 파일에서 가져왔어요.
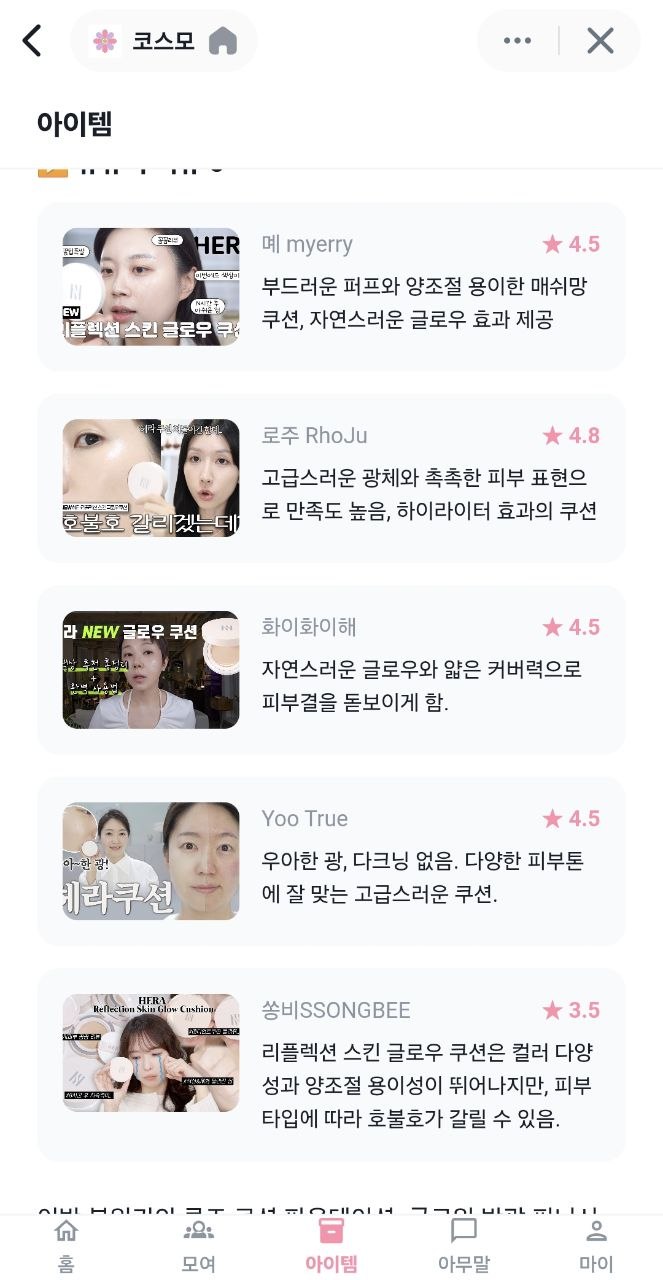
결과물은 상품 하나에 유튜버별 한 줄 요약과 별점이 붙고, 평균이 “유튜브 리뷰 종합 점수”가 되는 형태예요. “호불호 갈릴 수 있음” 같은 부정 평가도 그대로 들어가요.
수집만 집 PC에서, 저장과 서비스는 클라우드에서 하는 구조
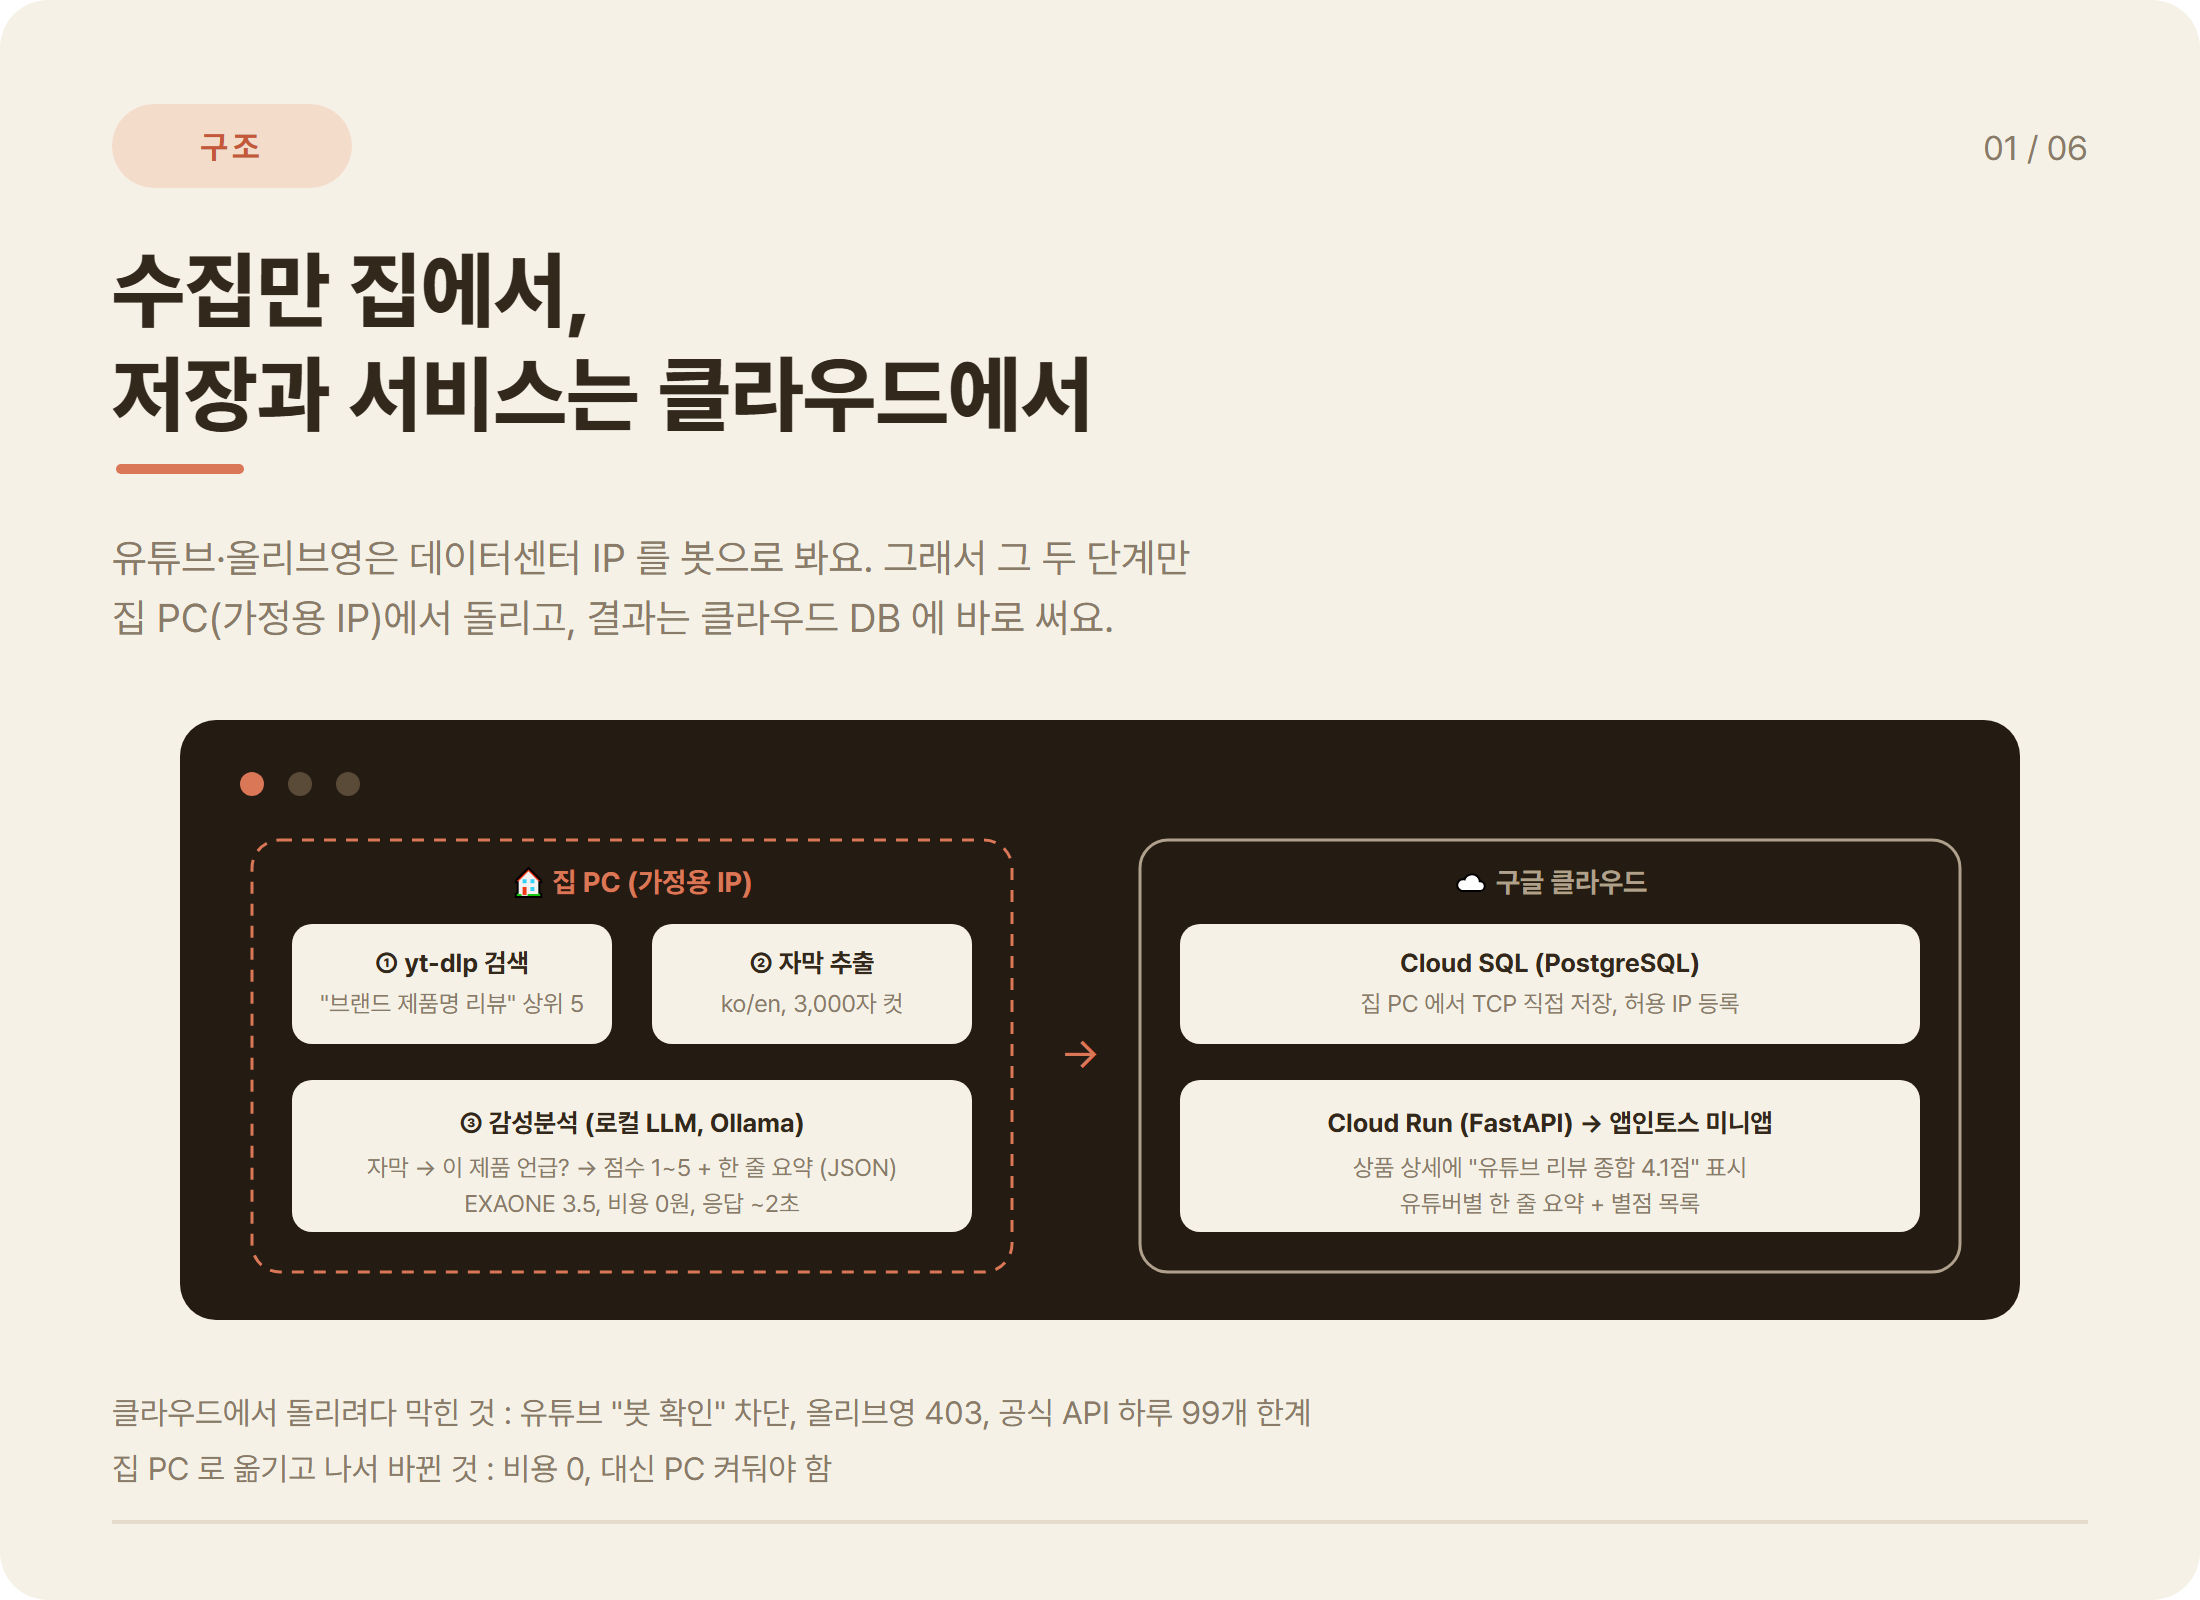
처음 설계는 전부 클라우드였어요. 올리브영 크롤링과 유튜브 수집을 Cloud Run 작업으로 매일 새벽 실행할 계획이었죠. 4월 초 실제로 올려보니 유튜브와 올리브영 모두 데이터센터 IP를 봇으로 판단해 차단했어요.
그래서 구조를 나눴어요. 외부 사이트에 요청하는 두 단계(검색, 자막)만 집 PC에서 실행하고, 감성분석도 집 PC의 로컬 LLM으로 처리하고, 결과는 Cloud SQL에 직접 써요. 앱이 읽는 API 서버는 그대로 Cloud Run이에요. 사용자 입장에서 달라진 것은 없고, PC를 켜둬야 한다는 조건만 생겼어요.
클라우드에서 막힌 에러 원문 4가지
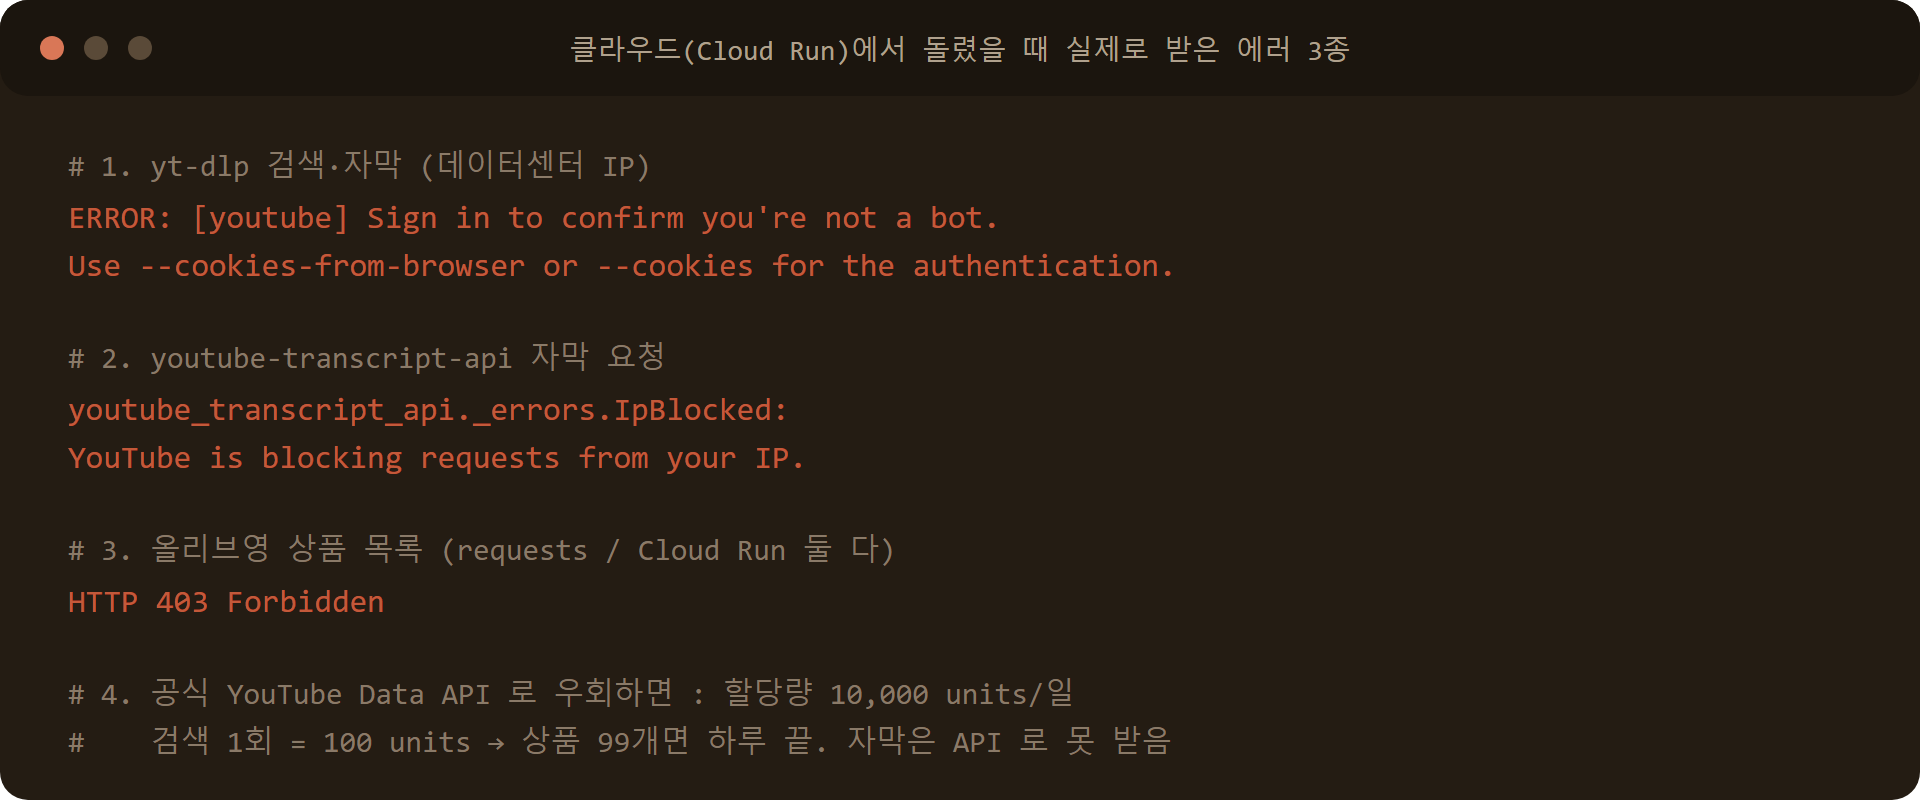
클라우드(Cloud Run)에서 돌렸을 때 실제로 받은 에러 3종
# 1. yt-dlp 검색·자막 (데이터센터 IP)
ERROR: [youtube] Sign in to confirm you're not a bot.
Use --cookies-from-browser or --cookies for the authentication.
# 2. youtube-transcript-api 자막 요청
youtube_transcript_api._errors.IpBlocked:
YouTube is blocking requests from your IP.
# 3. 올리브영 상품 목록 (requests / Cloud Run 둘 다)
HTTP 403 Forbidden
# 4. 공식 YouTube Data API 로 우회하면 : 할당량 10,000 units/일
# 검색 1회 = 100 units → 상품 99개면 하루 끝. 자막은 API 로 못 받음- yt-dlp “Sign in to confirm you’re not a bot”: 검색과 자막 모두 이 메시지로 끝났어요. 데이터센터 IP에서 로그인 없이 요청하면 거의 항상 걸려요.
- youtube-transcript-api “IpBlocked”: 자막(timedtext) 요청 단계에서 발생해요. 한 번 플래그되면 쿠키를 붙여도 반나절 이상 유지돼요.
- 올리브영 403 Forbidden: requests든 Cloud Run이든 동일하게 403. Selenium + 헤드리스 크롬으로 집 PC에서 해결했고, 별도 글에서 다뤄요.
- 공식 YouTube Data API 할당량: 하루 10,000 units, 검색 1회 100 units라 상품 99개에서 끝나요. 자막은 이 API로 받을 수 없어요.
4번이 결정적이었어요. 공식 API는 안정적이지만 상품 수백 개를 매일 갱신하는 구조가 불가능했어요. 그래서 API 키 없이 검색하는 yt-dlp를 쓰고, 대신 차단되지 않는 속도를 코드로 지켜야 했어요.
1단계 검색: yt-dlp로 API 키 없이
run_youtube_local.py : 검색 (yt-dlp, API 키·할당량 없음)
query = f"{brand} {core_name} 리뷰"   # 용량·기획·괄호는 미리 제거
ydl_opts = {
    "quiet": True, "skip_download": True, "ignoreerrors": True,
    "cookiefile": "youtube_cookies.txt",   # 로그인 쿠키, 있으면 항상 첨부
}
with yt_dlp.YoutubeDL(ydl_opts) as ydl:
    r = ydl.extract_info(f"ytsearch5:{query}", download=False)
for e in r["entries"]:
    if e["view_count"] < 10_000: continue      # 조회수 1만 미만 제외
    videos.append({"video_id": e["id"], "channel": e["channel"], ...})
# 검색 후 random.uniform(1, 3) 초 대기. 고정 딜레이는 패턴으로 잡혀요
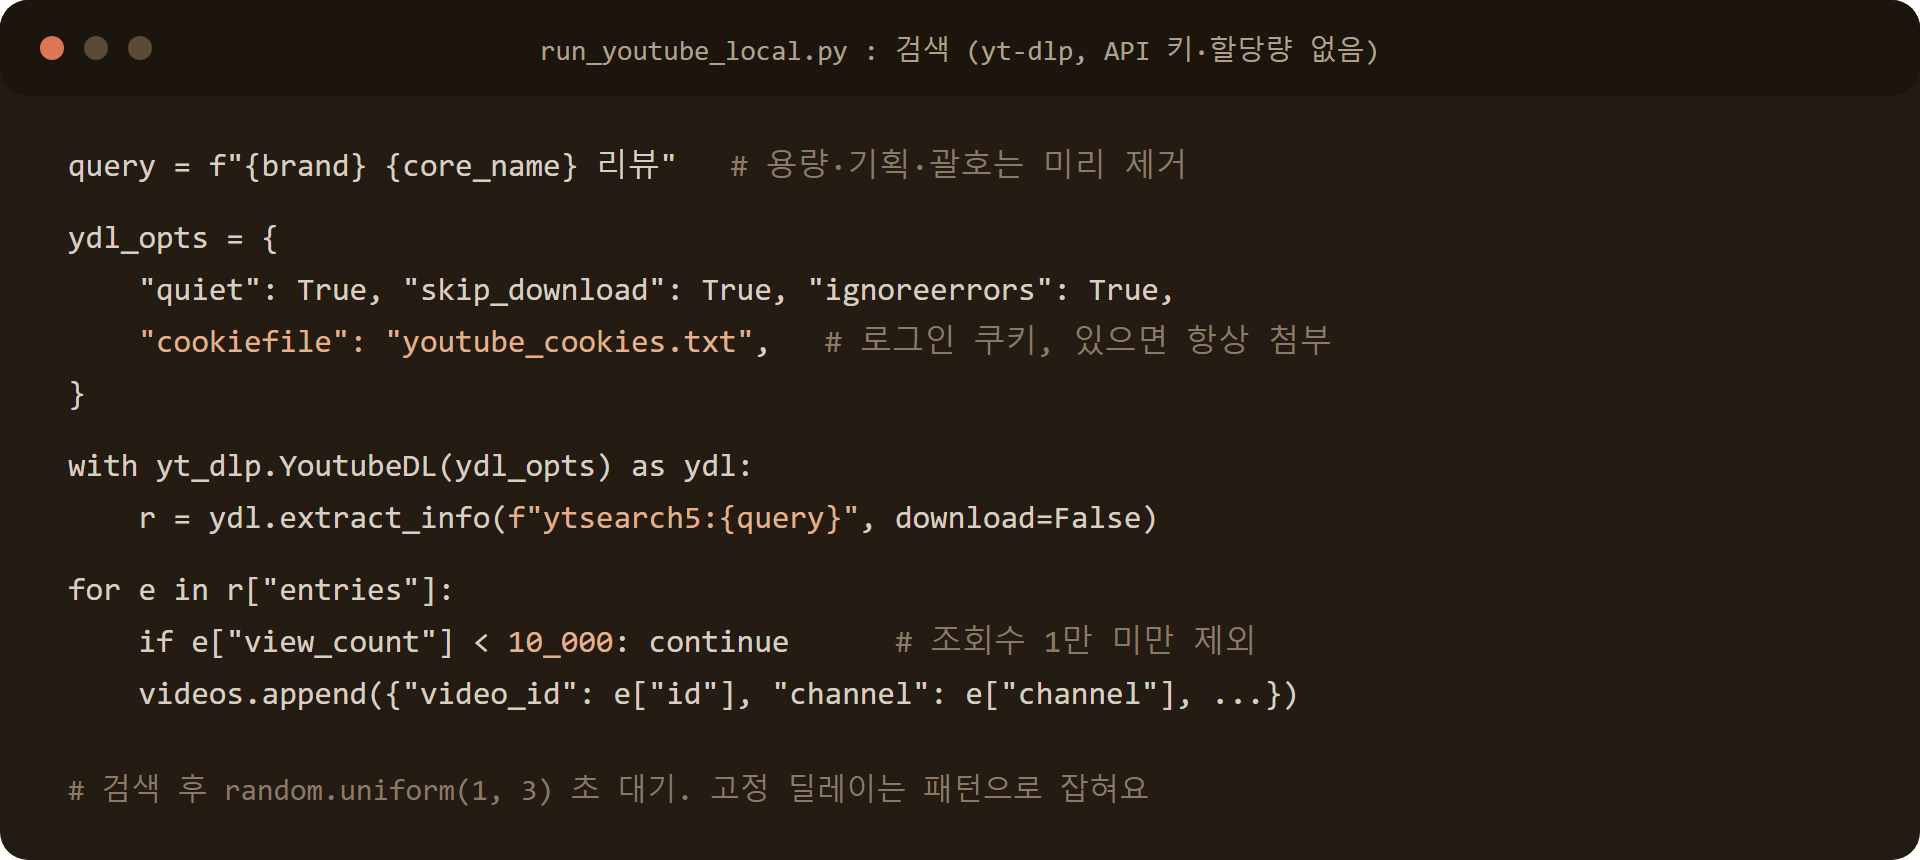
상품마다 “브랜드 + 핵심 제품명 + 리뷰”로 검색해 상위 5개 영상을 가져와요. “50ml 기획 (리필+파우치)” 같은 꼬리를 정규식으로 제거해야 매칭률이 올라가요. 클로드코드가 실제 데이터를 보고 만든 규칙이에요.
조회수 1만 미만은 제외해요. 리뷰보다 언박싱이나 광고인 경우가 많았어요. 로그인 쿠키 파일이 있으면 항상 첨부해요. 비로그인 요청은 봇으로 판정되기 쉬워요.
2단계 자막 추출: 캐시, 재시도, 폴백 4단계
자막 추출 : 캐시 → API 재시도 → yt-dlp 폴백 (4단계)
# 1. DB 캐시  같은 영상은 두 번 안 받음
if cached := await get_cached_transcript(db, video_id): return cached
# 2. youtube-transcript-api 1.2.x  (0.6 과 API 가 완전히 달라요)
api = YouTubeTranscriptApi(http_client=session_with_cookies)
for attempt in range(3):
    try:
        snippets = api.fetch(video_id, languages=["ko", "en"])
        return " ".join(s.text for s in snippets)[:3000]
    except (NoTranscriptFound, TranscriptsDisabled): return None
    except Exception as e:
        if "IpBlocked" in type(e).__name__: await asyncio.sleep([30, 120][attempt])
# 3. 3회 실패 시 yt-dlp 로 자막 파일(자동 생성 포함) 폴백
# 4. 둘 다 실패 → None (그 영상은 건너뜀)
# v2 에서는 2번을 아예 빼고 yt-dlp 자막만 씁니다 (IpBlocked 재시도 자체가 불필요)
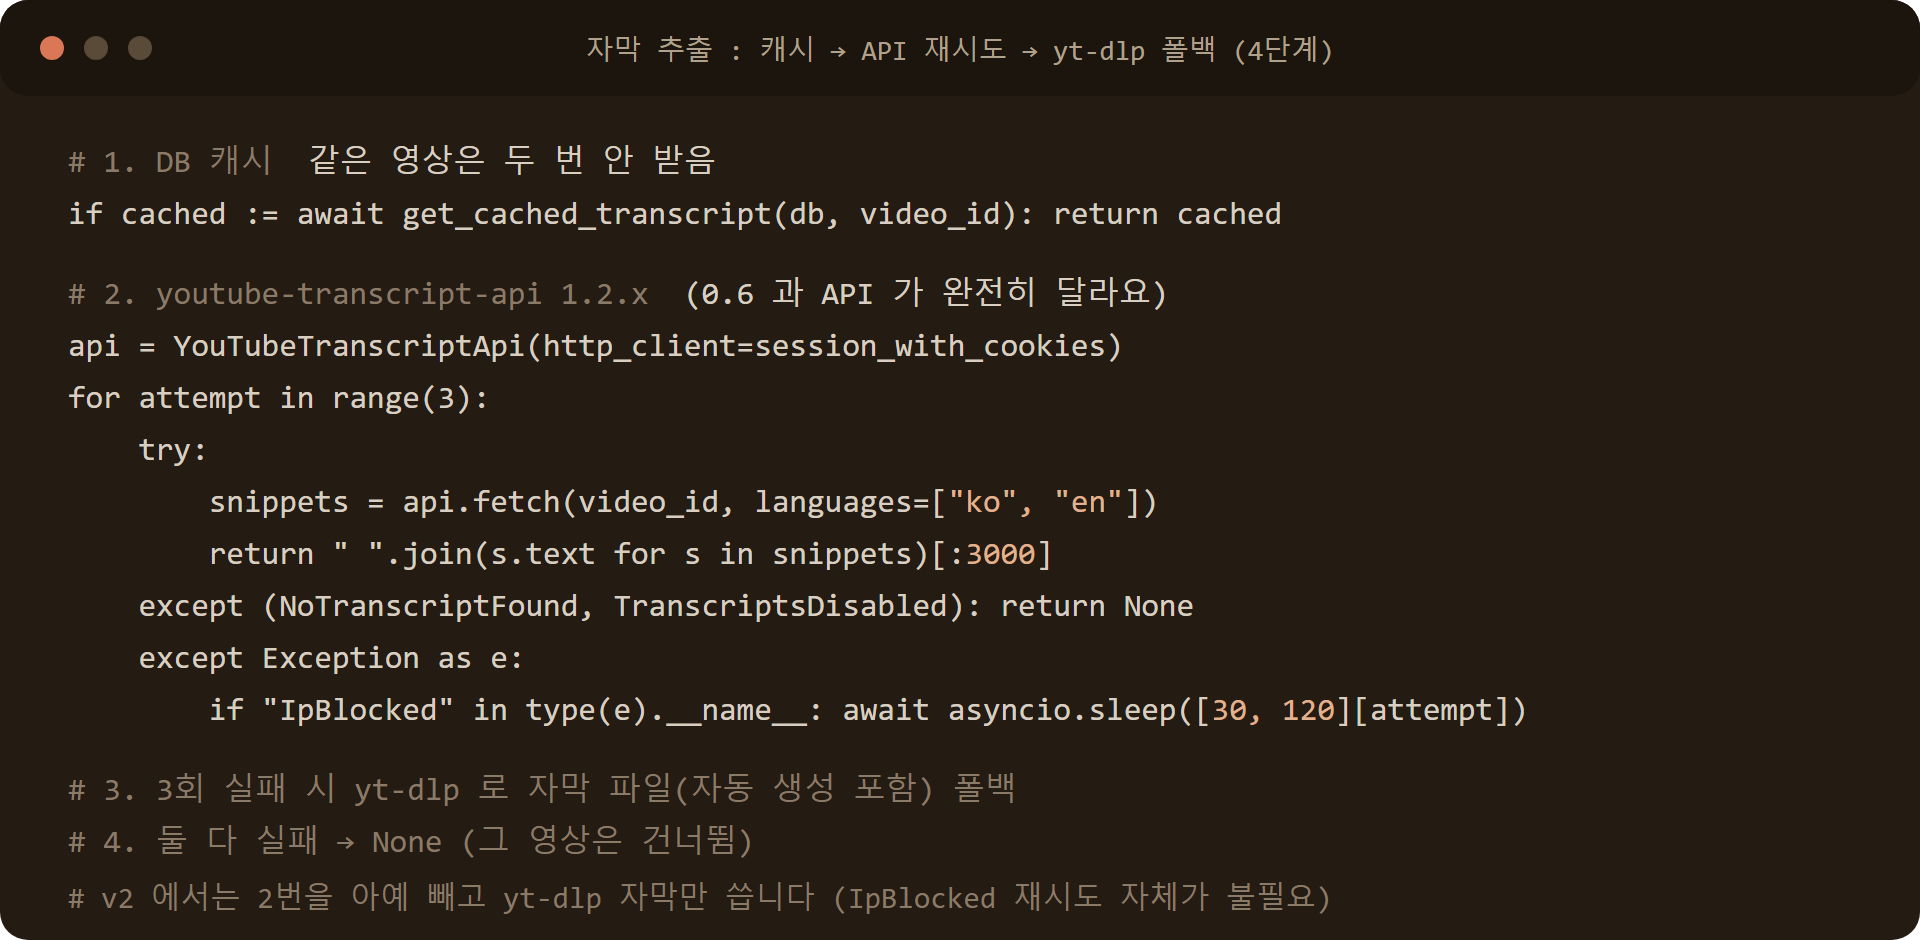
같은 영상은 두 번 받지 않아요. DB에 자막이 있으면 캐시를 써요. 없으면 youtube-transcript-api로 한국어, 영어 순으로 자막을 받고 3,000자에서 잘라요. 감성분석에 그 이상은 필요 없었어요.
IpBlocked가 나면 30초, 120초 대기 후 재시도하고, 3회 실패 시 yt-dlp의 자막 파일 추출로 폴백해요. 자막이 없는 영상(NoTranscriptFound, TranscriptsDisabled)은 재시도 없이 건너뛰어요.
이 라이브러리 때문에 하루를 잃은 적이 있어요. 0.6 버전과 1.2 버전의 함수 이름이 완전히 달라 클로드코드가 옛 문법으로 작성한 코드가 계속 실패했어요. 지금은 v2 스크립트에서 이 라이브러리를 제거하고 yt-dlp 자막만 써요. 재시도 자체가 필요 없어졌어요.
3단계 감성분석: 로컬 LLM으로 점수와 한 줄 요약
korean_sentiment.py : 로컬 LLM 으로 점수 + 한 줄 요약 (Ollama, EXAONE 3.5)
prompt = f"""당신은 K-뷰티 리뷰 분석 전문가입니다.
아래 자막에서 '{product_name}' 에 대한 평가만 골라 JSON 으로 답하세요.
{ "score": 1.0~5.0 (1=매우부정, 3=보통, 5=매우긍정),
  "summary": "제품 특화 한 줄 요약" }
자막: {transcript[:3000]}"""
resp = requests.post("http://localhost:11434/api/generate", json={
    "model": "exaone3.5", "prompt": prompt, "stream": False,
    "options": {"temperature": 0.1, "num_predict": 150}}, timeout=120)
score = max(1.0, min(5.0, float(result["score"])))   # 범위 보정
[EXAONE] 헤라 리플렉션 스킨 글로우 쿠션: score=3.5,
  summary=컬러 다양성과 양조절 용이성이 뛰어나지만, 피부 타입에 따라 호불호가 갈릴 수 있음.
# 이 한 줄이 그대로 앱의 "유튜버별 요약" 이 돼요. 여러 유튜버 평균 = 종합 점수
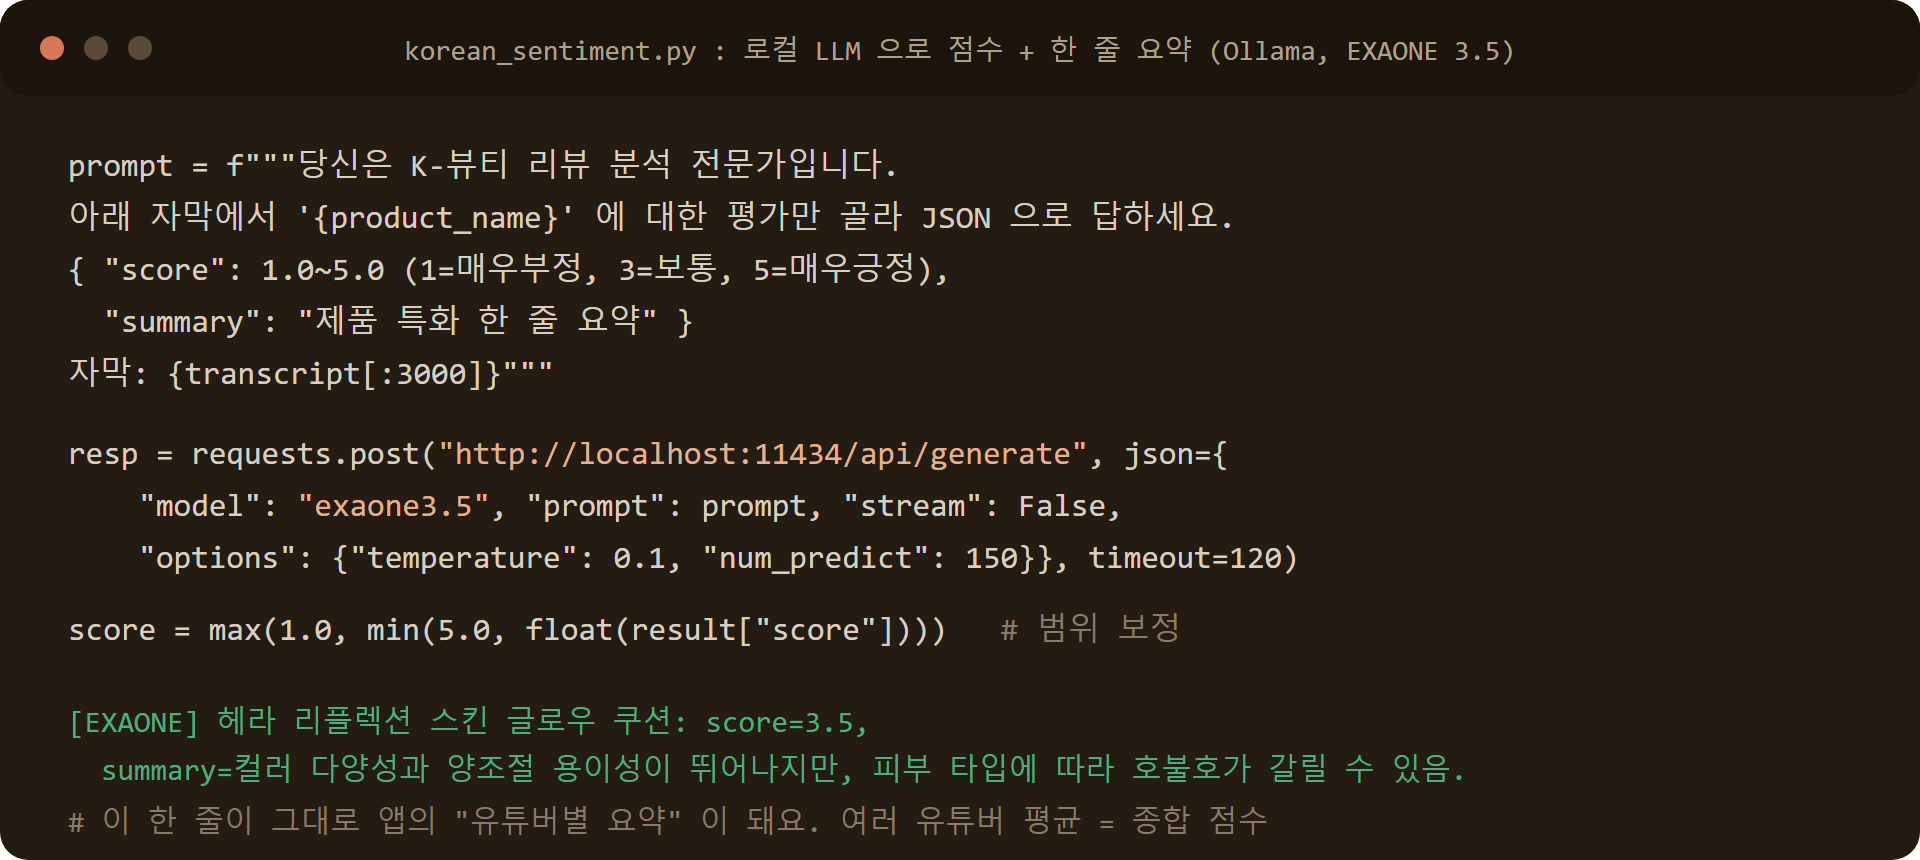
자막을 로컬 LLM(Ollama의 EXAONE 3.5)에 넣고 “이 제품에 대한 평가만 골라 1~5점과 한 줄 요약을 JSON으로” 요청해요. temperature 0.1로 같은 자막이면 거의 같은 답이 나오게 하고, 점수는 1~5 범위로 보정해요.
처음엔 긍정어, 부정어 사전으로 세는 키워드 방식이었어요. “촉촉한데 무겁다” 같은 문장을 잡지 못해 LLM으로 바꿨고, 집 PC GPU로 돌리니 비용은 0원이에요. 스크린샷의 “컬러 다양성과 양조절 용이성이 뛰어나지만, 피부 타입에 따라 호불호가 갈릴 수 있음. 3.5점”이 이 프롬프트의 실제 출력이에요.
차단되지 않는 속도: 전부 랜덤 딜레이
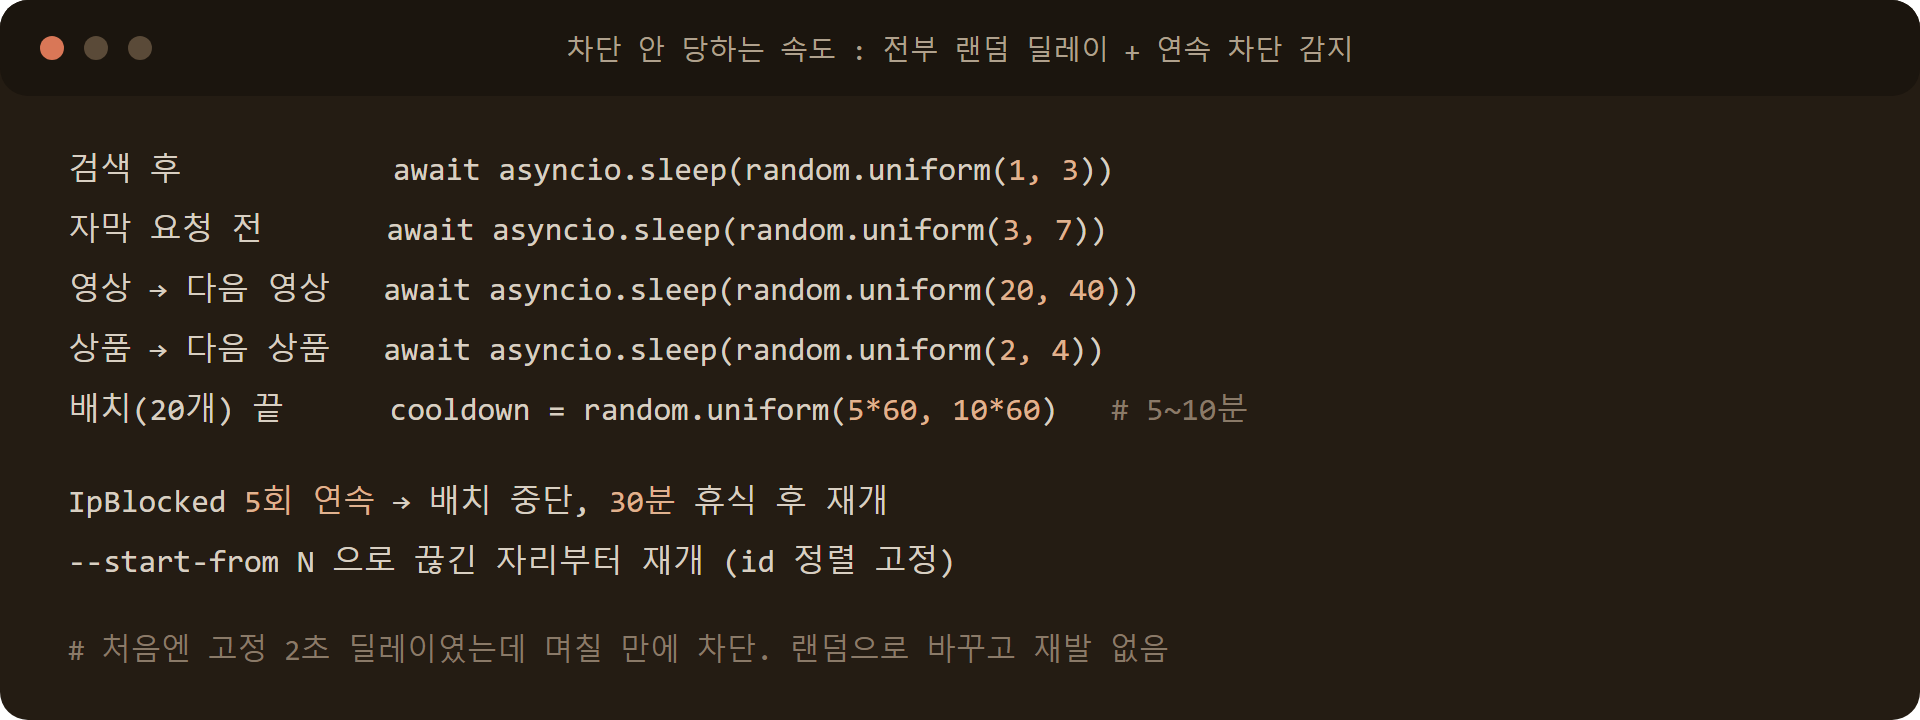
차단 안 당하는 속도 : 전부 랜덤 딜레이 + 연속 차단 감지
검색 후            await asyncio.sleep(random.uniform(1, 3))
자막 요청 전       await asyncio.sleep(random.uniform(3, 7))
영상 → 다음 영상   await asyncio.sleep(random.uniform(20, 40))
상품 → 다음 상품   await asyncio.sleep(random.uniform(2, 4))
배치(20개) 끝      cooldown = random.uniform(5*60, 10*60)   # 5~10분
IpBlocked 5회 연속 → 배치 중단, 30분 휴식 후 재개
--start-from N 으로 끊긴 자리부터 재개 (id 정렬 고정)
# 처음엔 고정 2초 딜레이였는데 며칠 만에 차단. 랜덤으로 바꾸고 재발 없음| 구간 | 대기 | 이유 |
|---|---|---|
| 검색 후 | 1~3초 랜덤 | 검색 요청 간격 분산 |
| 자막 요청 전 | 3~7초 랜덤 | 자막 API가 가장 민감 |
| 영상 사이 | 20~40초 랜덤 | 같은 상품의 영상 5개 연속 요청 방지 |
| 상품 사이 | 2~4초 랜덤 | 패턴 분산 |
| 배치 20개 종료 | 5~10분 랜덤 | 장시간 패턴 차단 |
| IpBlocked 5회 연속 | 30분 휴식 | 플래그 상태에서 추가 요청은 악화 |
처음엔 고정 2초 딜레이였는데 며칠 만에 차단됐어요. 간격이 일정하면 그 자체가 봇 패턴이에요. 전부 랜덤으로 바꾸고 배치 쿨다운을 넣은 뒤 재발이 없어요.
트러블슈팅: 실제로 겪은 문제 5개
1. ERROR: [youtube] Sign in to confirm you’re not a bot
원인: 비로그인 요청 또는 데이터센터 IP.
해결: 집 PC에서 실행 + 브라우저에서 내보낸 쿠키 파일(Netscape 포맷)을 yt-dlp와 자막 세션에 함께 첨부. yt-dlp는 --cookies-from-browser chrome 옵션으로도 가능해요.
2. youtube_transcript_api._errors.IpBlocked 가 쿠키를 붙여도 계속 남
원인: 이미 IP가 플래그된 상태. 차단은 시간 기반이라 즉시 풀리지 않아요.
해결: 반나절 이상 완전히 중지. 쿨다운 중 계속 실행하면 0건만 쌓이고 차단이 길어져요.
3. 저장 0건인데 에러도 없음
원인: 로그 리다이렉트 실패를 “실행 안 됨”으로 오판하고 스크립트를 두 번 실행. 같은 IP에서 프로세스 2개가 동시에 요청하면 바로 플래그돼요.
해결: 재시작 전 실행 중 프로세스 0개 확인 후 1개만 실행. 10시간 동안 89개 상품을 처리하고 저장 0건, IpBlocked 112회를 기록한 날 배운 규칙이에요.
4. AttributeError: ‘YouTubeTranscriptApi’ object has no attribute ‘find_generated_transcript’
원인: 0.6 버전 문법. 1.2 버전은 인스턴스를 만들고 fetch(video_id, languages=[...])를 써요.
해결: pip install -U youtube-transcript-api 후 호출부 전면 교체, 또는 v2처럼 yt-dlp 자막으로 통일.
5. 감성분석이 전부 3.0점
원인: Ollama가 실행되지 않아 연결 실패 → 기본값 3.0 반환.
해결: 수집 전 ollama serve 확인. 로그에 “EXAONE 연결 실패”가 찍히면 이 경우예요.
자주 묻는 질문
Q. 유튜브 자막 추출은 합법인가요?
공개된 자막을 개인 프로젝트에서 분석 용도로 가져오고 영상이나 자막을 재배포하지 않아요. 다만 유튜브 약관상 자동화 접근은 제한 대상이라 상업 서비스로 확장할 땐 공식 API와 라이선스를 검토해야 해요. 이 글은 기술 기록이지 권장이 아니에요.
Q. 집 PC는 얼마나 켜둬야 하나요?
상품 100개 기준 배치 5개, 쿨다운 포함 2~3시간이에요. 새벽에 한 번 실행하고 끄는 방식이라 전기 요금 체감은 없어요.
Q. 감성분석을 클로드 API로 하면 안 되나요?
가능하고 정확도는 더 높을 거예요. 하지만 자막 3,000자 × 상품당 영상 5개 × 매일 수백 개면 비용이 매달 발생해요. 로컬 LLM은 0원이라 이 용도엔 충분했어요.
Q. 클로드코드가 이 파이프라인을 얼마나 작성했나요?
코드는 거의 전부예요. 사람이 한 것은 “클라우드에서 막힌다”를 확인하고 “집에서 돌리자”고 결정한 것, 차단될 때마다 로그를 전달한 것이에요. 랜덤 딜레이 값과 제품명 정리 규칙은 클로드코드가 실제 로그를 보고 제안했어요.
참고 자료
- yt-dlp (GitHub, Unlicense)
- youtube-transcript-api (GitHub, MIT)
- YouTube Data API 할당량 문서 (기본 10,000 units/일)
- Ollama / EXAONE 3.5 (LG AI Research, Hugging Face)
- 시리즈: 앱인토스 개발기 1편 · 2편 · 3편 · 클로드코드 사용방법
이 글은 개인 프로젝트 기록이고 특정 도구의 광고가 아니에요. 자동화 수집은 각 서비스 약관을 확인하고 본인 책임으로 하세요. 2026년 9월 9일 기준.
Leave a Reply